Documentación clínica escrita
por la voz del profesional
Un sistema capaz de capturar la voz del profesional, transcribirla en distintos idiomas y hacer una llamada a un LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude. que devuelve la información estructurada en distintos formatos. Es mi Trabajo Final de Grado, integrado en Streamly, la plataforma de gestión clínica en la que trabajo.
- Trabajo Final de Grado
- UPCUPC: Universitat Politècnica de Catalunya. Este trabajo es de la Escola Politècnica Superior d’Enginyeria de Manresa. · Manresa
- Titulación
- Ingeniería de Sistemas TIC
- Memoria
- UPCommons ↗
- Producto
- Streamly ↗
De la voz del profesional a la información estructurada
Antes de entrar en los detalles, esto es todo lo que hace el sistema. Cuatro pasos, donde el profesional tiene la última palabra.
- 01
Voz
El profesional habla, durante la visita o fuera de ella: en directo por el micrófono o subiendo un audio ya grabado.
- 02
Transcripción
Faster-WhisperModelo de reconocimiento de voz de OpenAI que pasa audio a texto. Faster-Whisper es una versión más rápida que funciona en nuestro propio servidor. la convierte en texto dentro de nuestro propio servidor, con el modelo adecuado para cada idioma. El audio no sale nunca de ahí.
caesen
- 03
LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude.
Recibe el texto con una instrucción adaptada al idioma y a la especialidad del centro. Solo saca lo que se ha dicho; no se inventa nada.
- 04
Información estructurada
Vuelve en el formato que elige el profesional, que la revisa y la guarda. Nada se guarda sin que él lo valide.
Ficha clínicaResumenDiagnósticoPlan terapéutico
1,68 spara transcribir un minuto de audio en catalán con GPUGPU: Graphics Processing Unit (unidad de procesamiento gráfico). La tarjeta gráfica: hace miles de cálculos a la vez, y por eso ejecuta los modelos de IA mucho más rápido que el procesador normal.1,43 sde media para generar la ficha con el LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude.
El objetivo era: automatizar una tarea para dar tiempo al profesional.
Que no tenga que pasar rato redactando la visita o el informe, ni durante la sesión ni después, y que ese tiempo vaya al paciente. En el sector de la salud, el tiempo no es simplemente un recurso, es la medida directa de la calidad de la atención.
Y ahora, en una visita real
Grabación completa de la defensa: desde la activación del módulo hasta la ficha clínica guardada en la visita del paciente.
Un problema que no me inventé
Entré en Streamly haciendo prácticas, y el TFGTFG: Trabajo de Fin de Grado. El proyecto final de la carrera, que se presenta y se defiende ante un tribunal. llegó en el momento justo. Los usuarios repetían una queja: rellenar la ficha de cada visita cuesta tiempo, y ese tiempo se lo quitas al paciente.
Al mismo tiempo, la empresa quería meter inteligencia artificial en el producto, pero no como un adorno. Quería que sirviera para algo concreto. Juntar las dos cosas dio forma al proyecto.
Era buscar una solución a un problema real.
Fueron casi seis meses, de febrero a julio de 2026: analizar el problema, construir el motor de transcripción, conectar el modelo de lenguaje, desplegarlo en la nube y, al final, contarlo todo en una memoria.
Durante la sesión, la mayoría de los profesionales apuntan solo el motivo de la visita o la marcan como hecha. El diagnóstico, el plan y la evolución quedan para después, en el rato entre paciente y paciente y tirando de memoria. El resultado: historias clínicas incompletas.
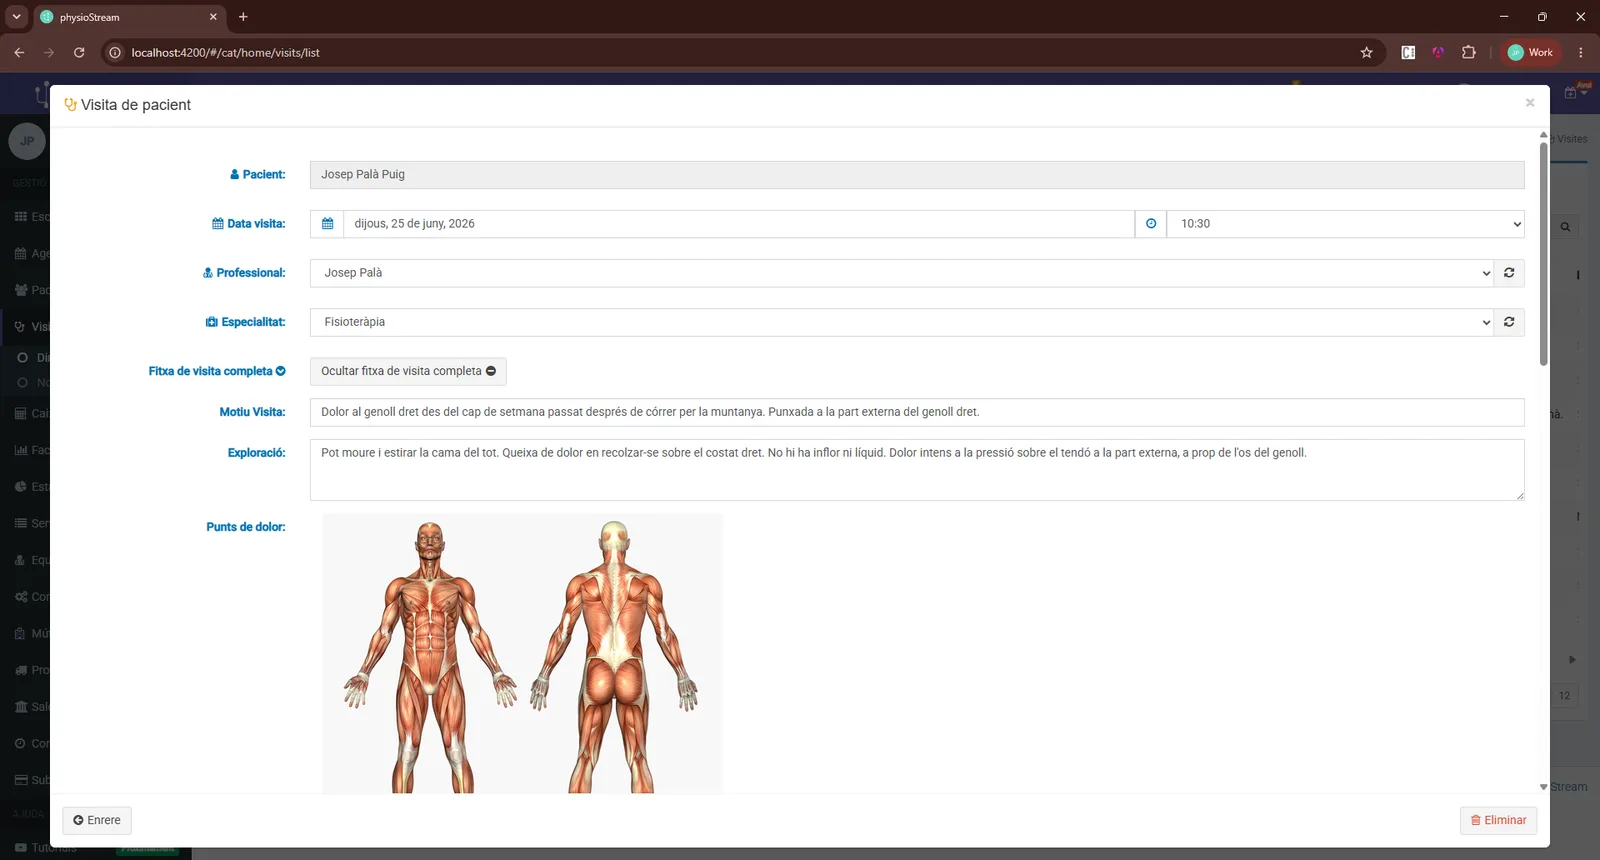
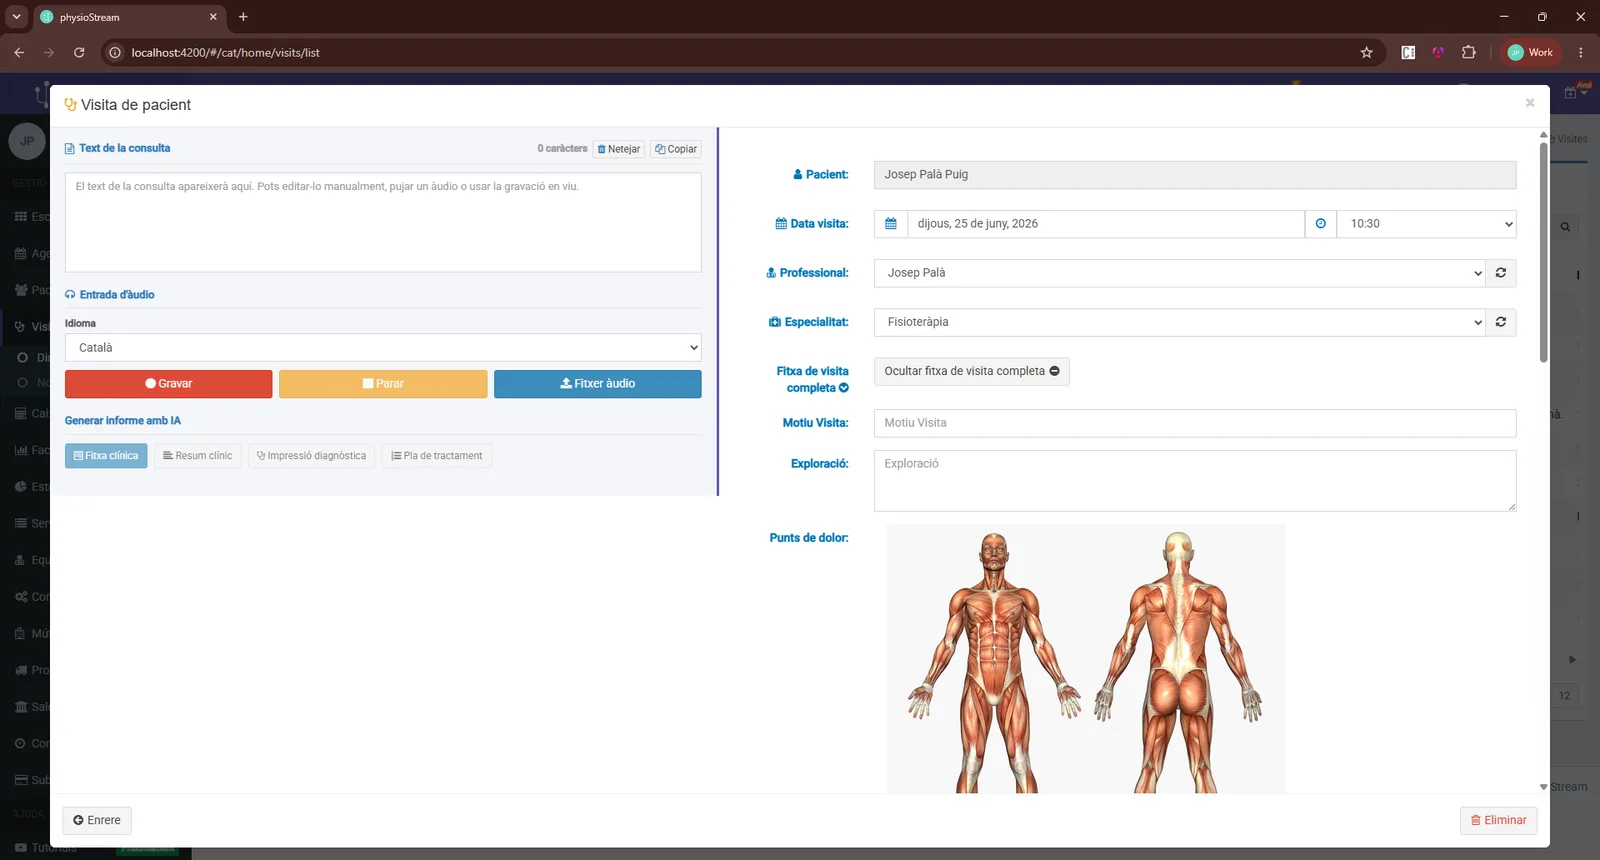
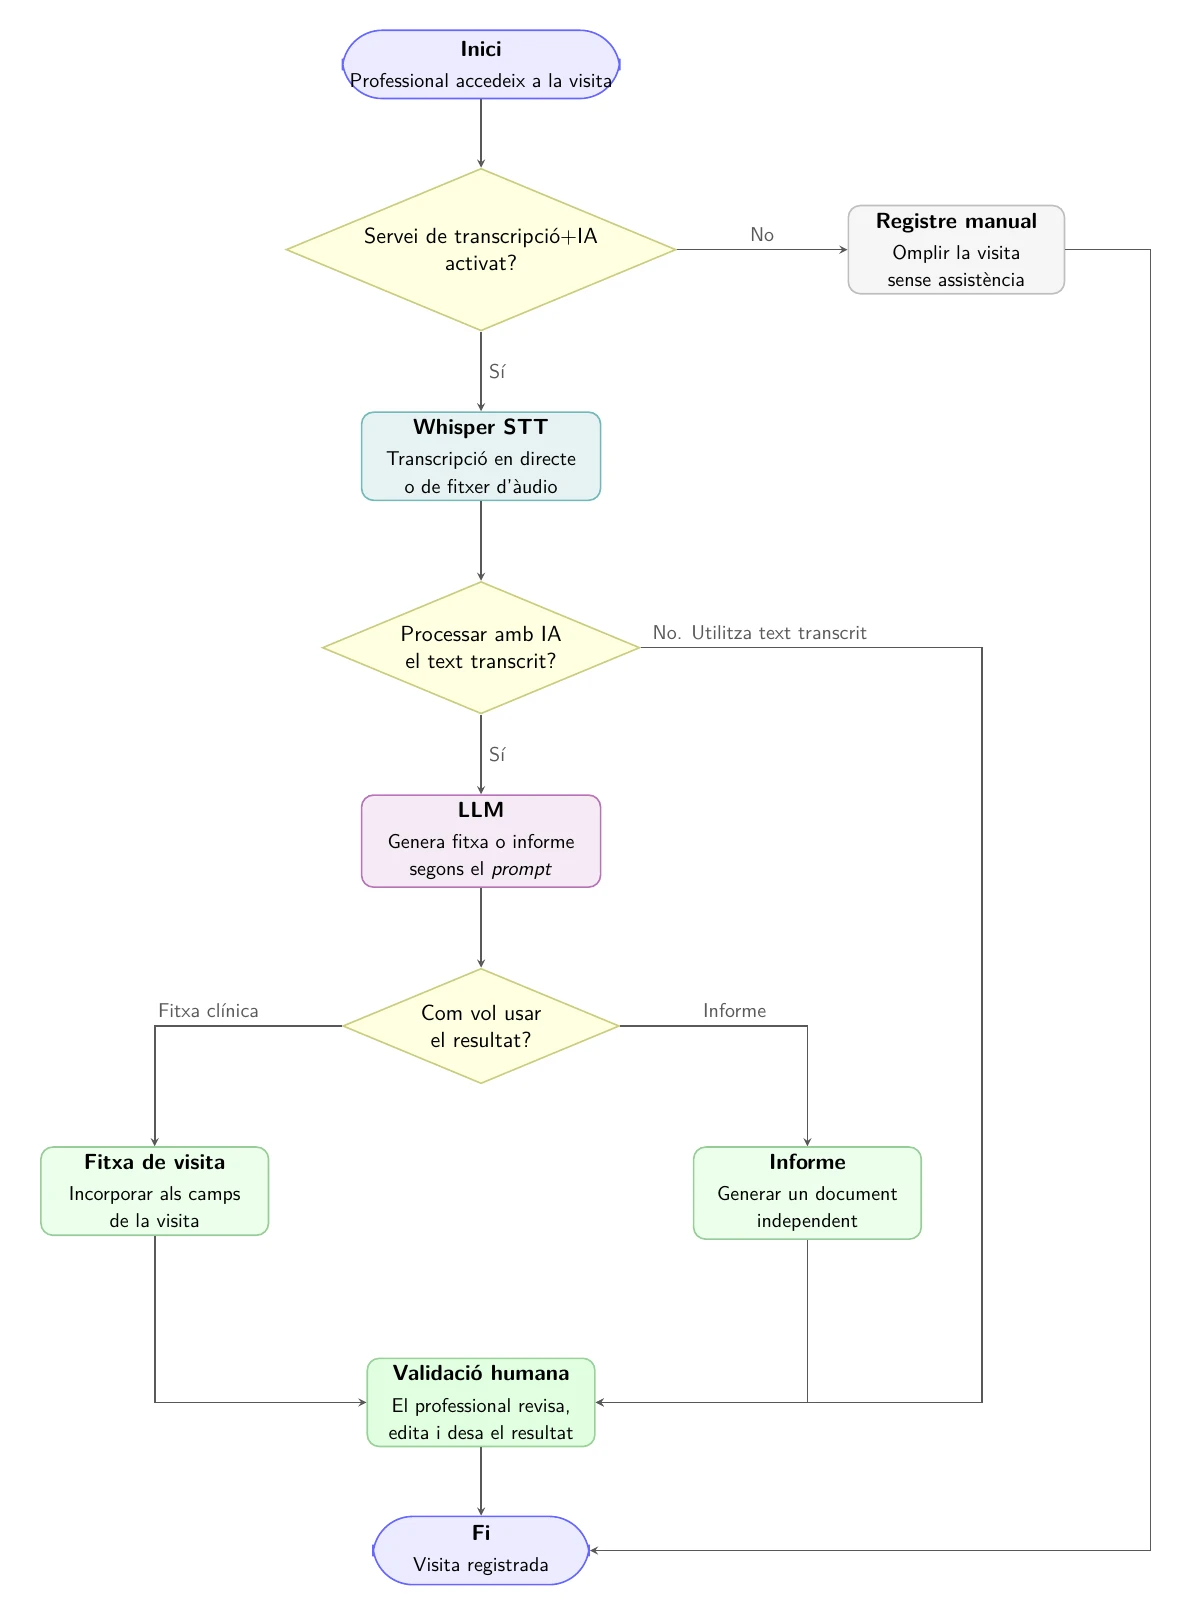
Flujo del sistema a alto nivel
Tres decisiones, y todas las toma el profesional
Lo diseñé para que la IA no haga nunca nada por su cuenta. El profesional activa el módulo, decide si quiere pasar el texto por el LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude. y, pase lo que pase, revisa el resultado antes de guardarlo. Si el módulo está apagado, la visita se rellena a mano, como siempre.
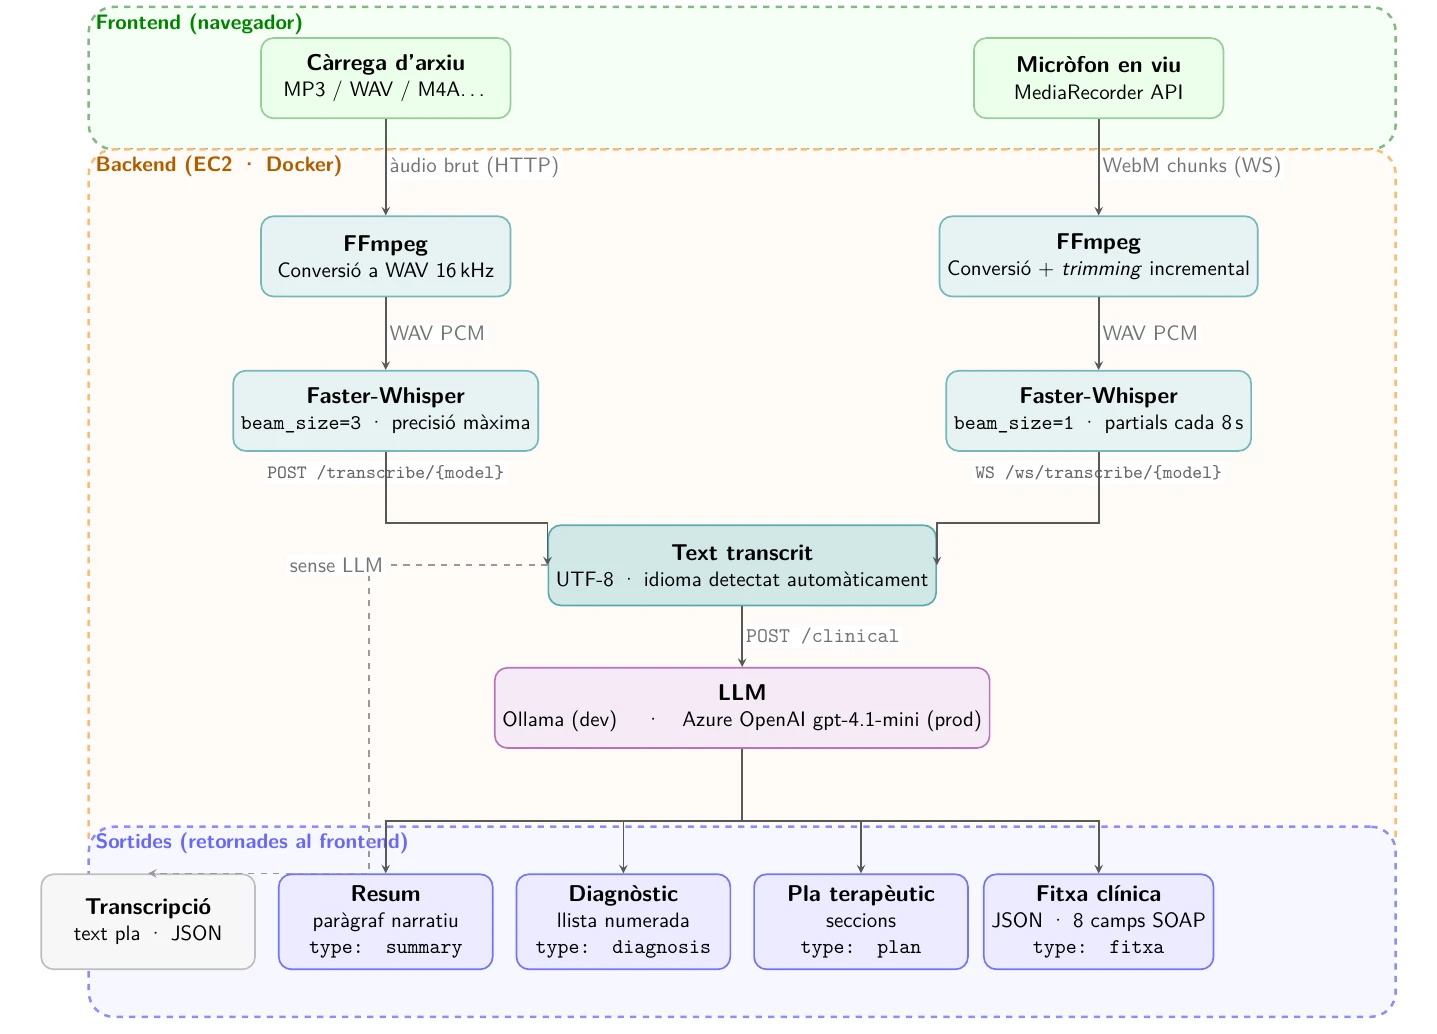
Pipeline de datos
Qué pasa entre la voz y la ficha
El audio entra por dos caminos: un fichero ya grabado o el micrófono, en directo. Los dos acaban en el mismo texto transcrito, y ahí el profesional elige entre quedarse con la transcripción tal cual o pedirle al LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude. una de las cuatro salidas: resumen, diagnóstico, plan terapéutico o ficha clínica.
Los detalles que no se ven
- Transcribir mientras hablas
- En directo, el navegador envía el audio a trozos por WebSocketConexión que queda abierta entre el navegador y el servidor para que los datos pasen en los dos sentidos sin tener que volver a pedirlos. y el servidor transcribe lo nuevo cada ocho segundos. Así el texto va apareciendo mientras el profesional habla, no cuando acaba.
- Un audio que no sabe cuánto dura
- El formato que graba el navegador (WebMFormato de audio y vídeo con el que graban los navegadores. Aquí, el audio que sale del micrófono.) no guarda la duración hasta que se acaba la grabación. Para saber cuántos segundos llevaba acumulados, el servidor convierte el audio y lo mide con las herramientas de FFmpegPrograma de código abierto para convertir y recortar audio y vídeo. Aquí pasa el audio al formato que necesita Whisper y mide su duración. cada vez.
- Palabras cortadas por la mitad
- Probándolo vi que a veces se perdía una sílaba justo en el corte entre dos trozos. La solución fue solapar medio segundo cada ventana con la anterior. No salió de ninguna teoría: salió de usarlo.
- La conexión que se cerraba antes de tiempo
- A veces el canal se cerraba antes de que llegara la transcripción final. Añadí un control para que el navegador espere esa última respuesta. Lo validé con más de cincuenta grabaciones y menos de un 5 % de fallos.
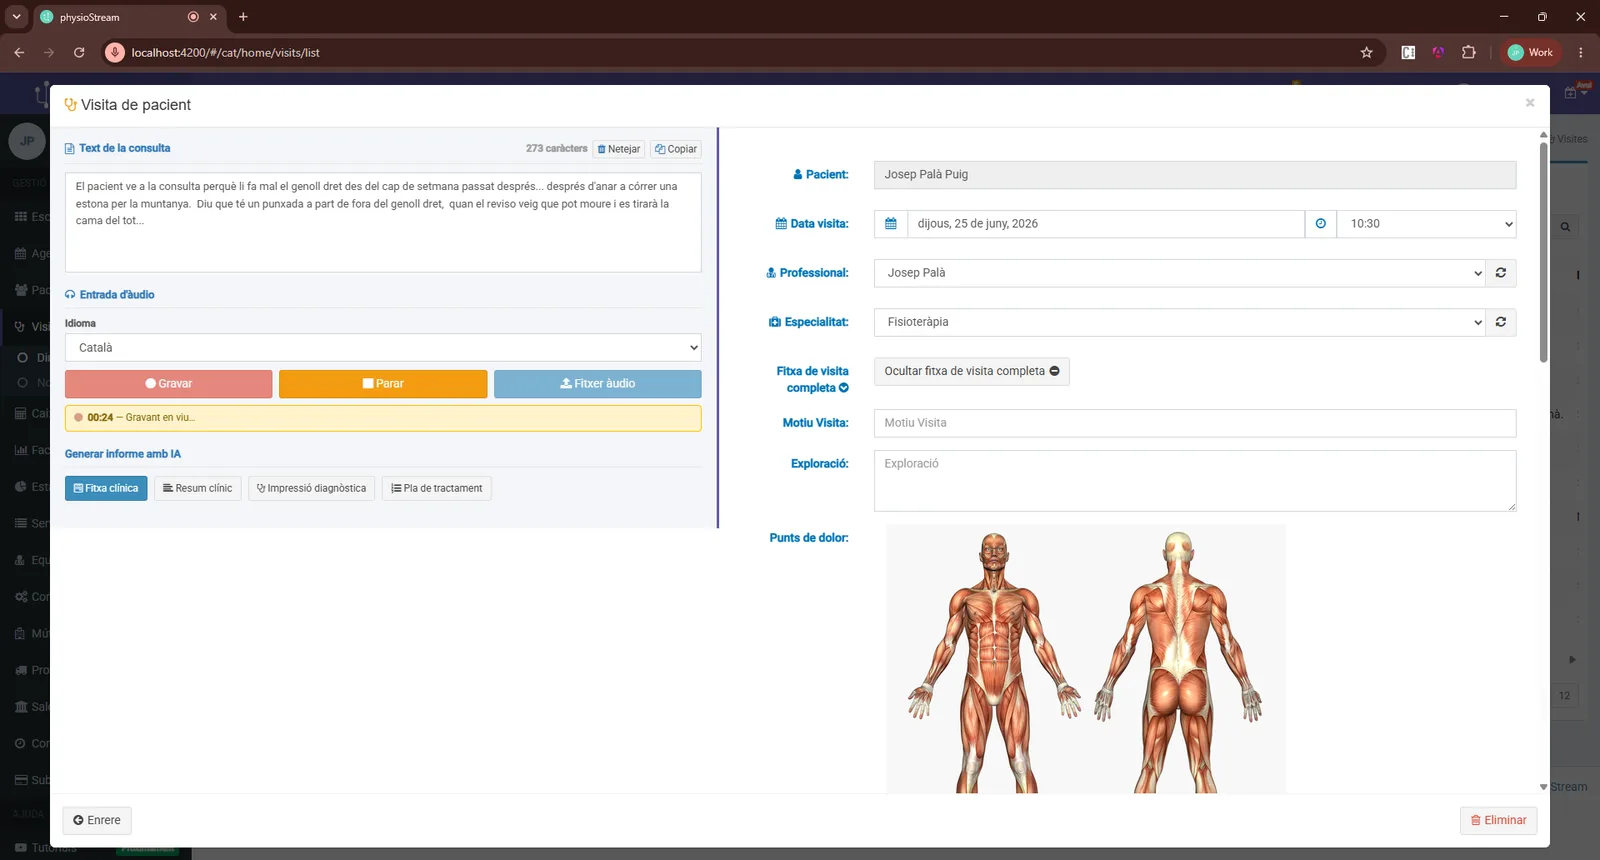
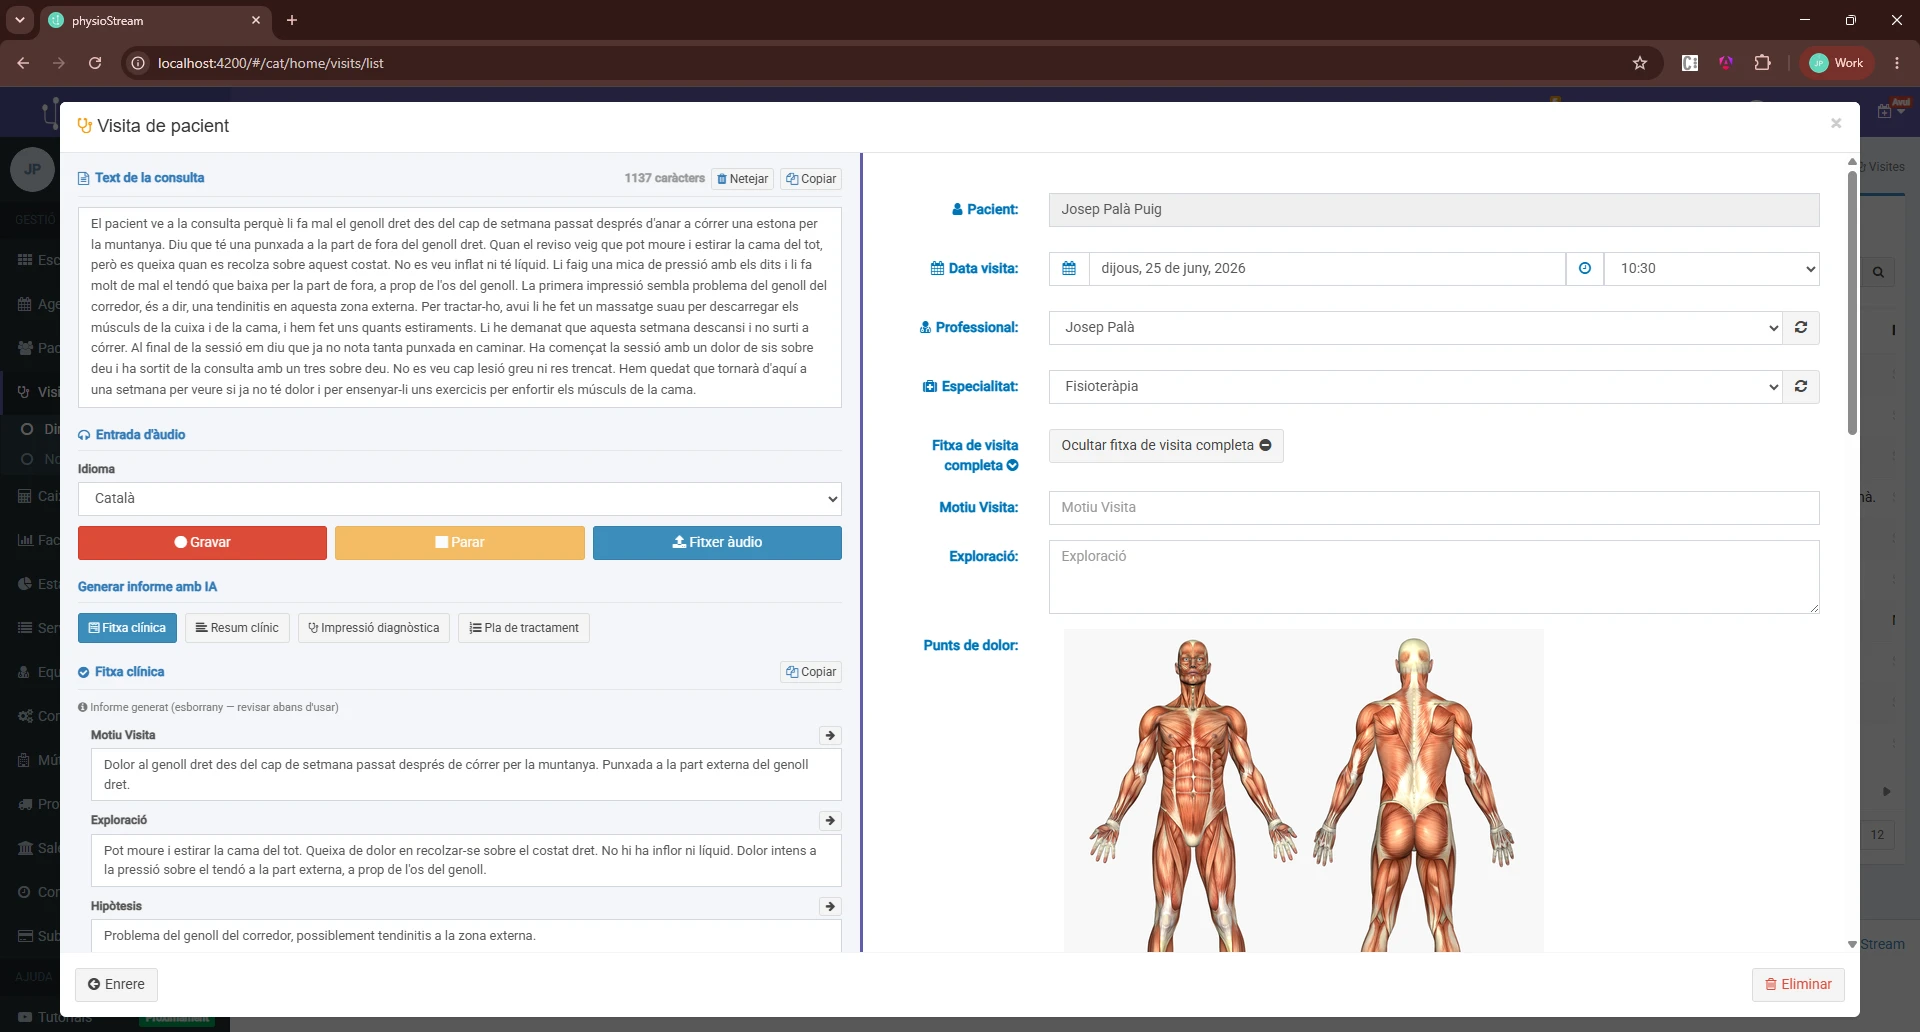
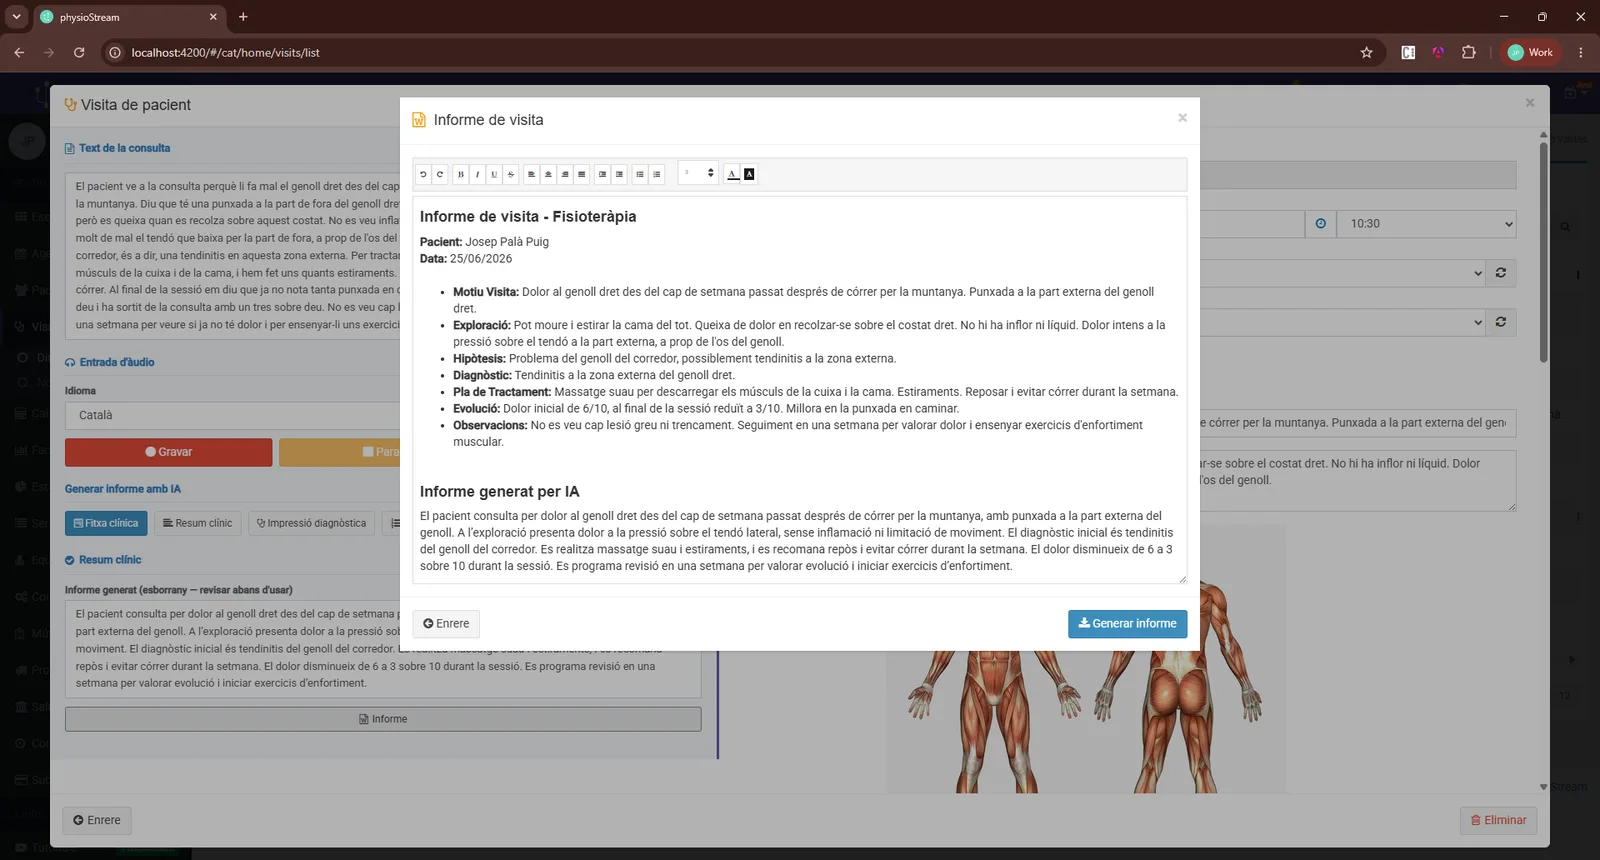
Cada centro tiene su propia ficha
Un fisioterapeuta y un podólogo no apuntan lo mismo. Por eso la ficha no está escrita en el código: los campos llegan desde la configuración de cada centro en Streamly, y con ellos se construye la instrucción que recibe el LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude.. Si un centro añade un campo, la ficha lo incluye sin tocar nada.
Todas las instrucciones llevan la misma regla: sacar solo lo que se dice en la transcripción, sin inventar nada. Si un campo no se menciona, se queda vacío. Y la temperaturaTemperatura: el parámetro que decide cuánto se arriesga el LLM al elegir cada palabra. Baja (cerca de 0): elige casi siempre la más probable y es previsible. Alta: se arriesga más y es más creativo. del LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude. está baja (0,3) para que se ciña al texto y no se ponga creativo.
Qué modelo entiende mejor el catalán médico
Para decidirlo preparé veinte audios de voz real de un minuto, diez en catalán y diez en castellano. Cada uno lee un texto clínico escrito a propósito con las palabras donde estos modelos suelen fallar: términos como cervicalgia o gonartrosis, referencias anatómicas y nombres de paciente. La medida es el WERWER: Word Error Rate (tasa de error por palabra). La proporción de palabras que la transcripción cambia, añade o se deja respecto a lo que se dijo de verdad. Cuanto más bajo, más fiel.: de cada cien palabras, cuántas salen mal.
- whisper-small media
- 29,65%
- aina-large-v3-ca mediana
- 12,53%
- ca_01
- ca_02
- ca_03
- ca_04alucinación ↓
- ca_05
- ca_06
- ca_07
- ca_08
- ca_09
- ca_10
El error de cada audio en la GPU de producción (Tesla T4). Pasa por encima de un audio o tócalo para leerlo solo.
El modelo del Barcelona Supercomputing Center pasa de cerca de una palabra errónea de cada tres a una de cada ocho. En nueve de los diez audios catalanes, AINAModelo de reconocimiento de voz especializado en catalán, del proyecto AINA del Barcelona Supercomputing Center. Es Whisper large-v3 ajustado con 710 horas de audio en catalán. se equivoca menos que whisperModelo de reconocimiento de voz de OpenAI que pasa audio a texto. Faster-Whisper es una versión más rápida que funciona en nuestro propio servidor.-small; solo pierde en el ca_04. Para el castellano no hacía falta: whisper-small ya obtiene un 13,53 %, así que el modelo especializado solo se aplica al catalán.
Uno de los veinte audios daba un error superior al 100 %. Parecía un fallo de medida, pero no lo era: al llegar a un tramo final con poca voz, el modelo entraba en bucle y se inventaba texto que no estaba en el audio.
De aquí salen dos decisiones. La cifra que se publica es la mediana, porque este único caso empujaba la media hasta el 18,78 %. Y la revisión del profesional quedó como paso obligatorio: ningún sistema de transcripción automática está libre de fallar en un caso concreto, por bueno que sea su error medio.
Por qué el sistema necesita GPU
AINAModelo de reconocimiento de voz especializado en catalán, del proyecto AINA del Barcelona Supercomputing Center. Es Whisper large-v3 ajustado con 710 horas de audio en catalán. es más preciso, pero también mucho más pesado. La diferencia entre procesarlo con el procesador normal o con una tarjeta gráfica decide si el sistema se puede usar durante la consulta o no.
Transcribir un audio de un minuto con AINA
Tesla T4Tarjeta gráfica (GPU) de NVIDIA pensada para servidores. Es la que lleva el servidor de AWS donde se hace la transcripción.. Suficientemente rápido para transcribir mientras dura la visita.
Veintinueve veces más lento. Inviable con el paciente delante.
Animación acelerada ×8. Los segundos son los medidos.
Del portátil a la nube
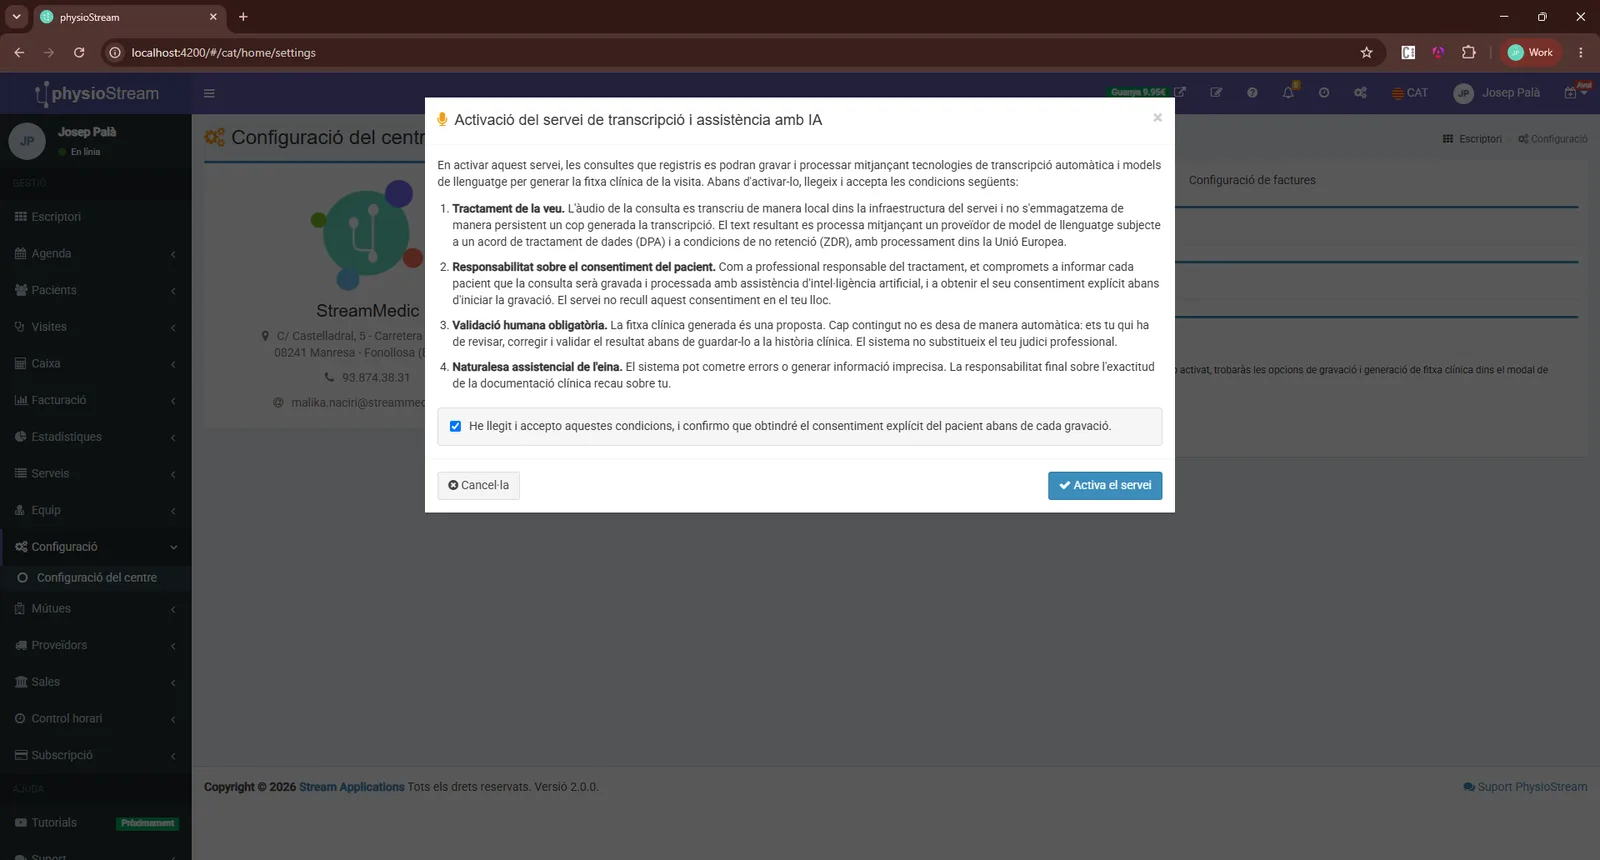
La primera versión corría entera en mi portátil: el servidor, la transcripción, un LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude. local y una capa para anonimizar el texto. Funcionaba, pero era lenta y no se la podía enseñar a nadie. La versión final vive en un servidor con GPUGPU: Graphics Processing Unit (unidad de procesamiento gráfico). La tarjeta gráfica: hace miles de cálculos a la vez, y por eso ejecuta los modelos de IA mucho más rápido que el procesador normal. en AWSAWS: Amazon Web Services. La nube de Amazon: alquila servidores y servicios por horas, sin tener que tener máquinas propias., empaquetada en DockerHerramienta que empaqueta una aplicación con todo lo que necesita en un «contenedor», para que funcione igual en cualquier servidor., y solo el texto sale hacia Azure OpenAIServicio de Microsoft que da acceso a los modelos de OpenAI, como GPT, desde sus servidores. Aquí es el LLM que genera la ficha en producción. para generar la ficha.
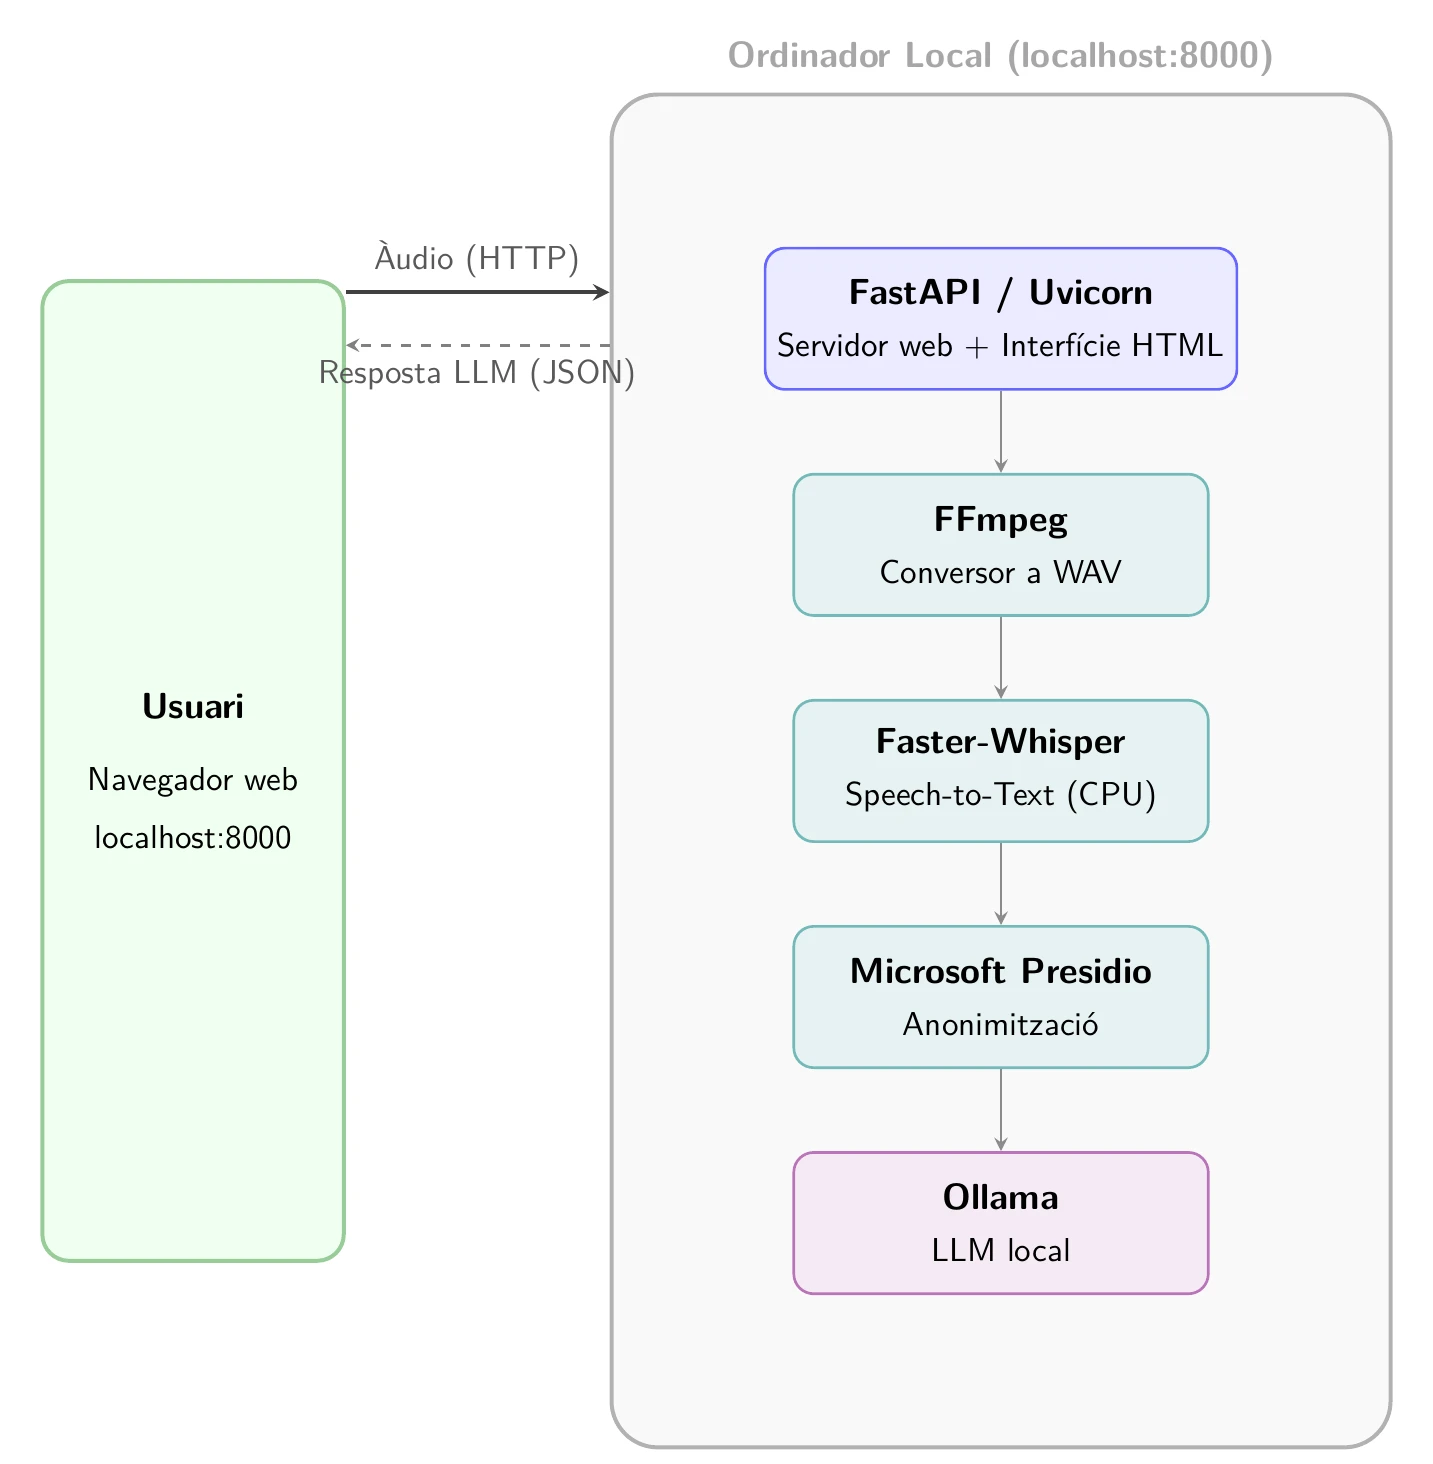
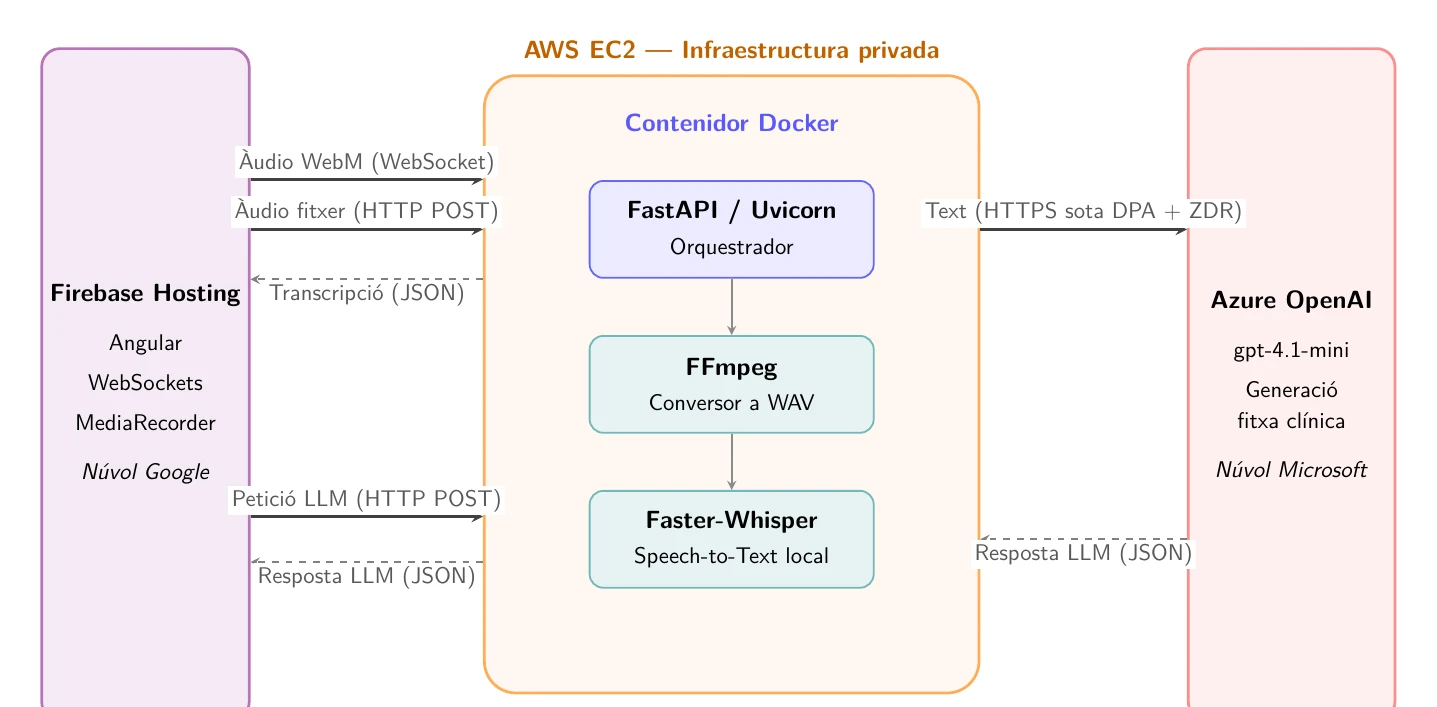
Una de las decisiones que más me enseñó fue quitar algo que ya funcionaba: la capa de anonimización.
Sobre el papel era buena idea: antes de enviar el texto al LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude., Microsoft PresidioHerramienta de código abierto de Microsoft que busca datos personales en un texto (nombres, teléfonos, DNI…) y los oculta. buscaba nombres, teléfonos o DNI y los sustituía. Pero con textos clínicos en catalán fallaba por los dos lados. Marcaba como datos personales palabras como «pàdel» o «drenatge» y, en cambio, dejaba pasar nombres y apellidos reales. Estropeaba el texto que recibía el LLM y encima daba una falsa sensación de seguridad. Una protección que funciona a medias puede ser peor que no tenerla, así que la quité y cambié el enfoque: el audio no sale nunca de la infraestructura, y el texto viaja con garantías contractuales.
La voz no sale de la infraestructura
El RGPDRGPD: Reglamento General de Protección de Datos. La ley europea que regula cómo se pueden usar los datos personales; los de salud tienen la protección más estricta. clasifica los datos de salud como categoría especial, el régimen más estricto. Esto condiciona la arquitectura antes que cualquier decisión de modelo: la transcripción se ejecuta siempre dentro de la infraestructura controlada y, hoy, el audio no viaja nunca a ningún tercero.
Audio, siempre local
Faster-WhisperModelo de reconocimiento de voz de OpenAI que pasa audio a texto. Faster-Whisper es una versión más rápida que funciona en nuestro propio servidor. corre dentro de la misma máquina que recibe la grabación. El fichero de audio no sale en ningún momento de la infraestructura del proyecto.
Qué cuesta y hacia dónde iría
Hoy la pieza cara es el servidor con GPUGPU: Graphics Processing Unit (unidad de procesamiento gráfico). La tarjeta gráfica: hace miles de cálculos a la vez, y por eso ejecuta los modelos de IA mucho más rápido que el procesador normal.: está encendido todo el día, se use o no, y transcribe los audios de uno en uno. Por eso los objetivos finales del trabajo apuntaban a quitar ese coste fijo de en medio.
476€/mes
Coste operativo
Instancia con GPUGPU: Graphics Processing Unit (unidad de procesamiento gráfico). La tarjeta gráfica: hace miles de cálculos a la vez, y por eso ejecuta los modelos de IA mucho más rápido que el procesador normal. y LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude., en un escenario de mil consultas diarias.
0€
Transcripción
No hay coste por uso: el modelo corre en la infraestructura propia.
- Todo por API
- Hacer la transcripción y la ficha con llamadas a la APIAPI: Application Programming Interface (interfaz de programación). La puerta por la que un programa le pide cosas a otro servicio, por ejemplo enviar un audio y recibir su texto. de OpenAI, sin un servidor propio para transcribir. Durante el trabajo se descartó porque el audio tenía que salir de la infraestructura; el objetivo era encontrar una opción que lo permitiera con las mismas garantías que ya tiene el texto: región europea, contrato y sin retención de datos.
- Servidores bajo demanda
- Una infraestructura tipo KubernetesSistema que gestiona muchos contenedores Docker a la vez: enciende más cuando hay trabajo, los apaga cuando no lo hay y reinicia uno si se cae. que levante servidores con la imagen DockerHerramienta que empaqueta una aplicación con todo lo que necesita en un «contenedor», para que funcione igual en cualquier servidor. cuando hay trabajo y los apague cuando no lo hay. Así el coste seguiría el uso real, en lugar de pagar siempre por el momento de más demanda.
Funciona. Otra cosa es activarlo
El sistema está integrado en Streamly y funciona en el entorno de preproducción. Lo que falta para usarlo con pacientes no es tecnología.
Hay dos barreras. La primera es el coste: la GPUGPU: Graphics Processing Unit (unidad de procesamiento gráfico). La tarjeta gráfica: hace miles de cálculos a la vez, y por eso ejecuta los modelos de IA mucho más rápido que el procesador normal. transcribe los audios de uno en uno, así que cuando muchos profesionales lo usan a la vez no basta con pagar un poco más; hay que añadir otro servidor entero, unos 443 € más al mes cada vez. La segunda es legal: trabajar con datos de salud de pacientes reales exige firmar el contrato con el proveedor, hacer una evaluación de impacto y definir cómo se pide el consentimiento.
El prototipo demuestra que el camino es viable. Recorrerlo depende de decisiones de empresa, no de código.
Y queda una pregunta sin respuesta: cuántos minutos ahorra de verdad en cada visita. Para eso hace falta un estudio con profesionales usándolo en su día a día, y es lo primero que haría antes de desplegarlo.
Qué me llevo
A medir antes de decidir. Elegir AINAModelo de reconocimiento de voz especializado en catalán, del proyecto AINA del Barcelona Supercomputing Center. Es Whisper large-v3 ajustado con 710 horas de audio en catalán. para el catalán no fue una intuición: fueron veinte audios y una tabla.
Que quitar también es diseñar. PresidioHerramienta de código abierto de Microsoft que busca datos personales en un texto (nombres, teléfonos, DNI…) y los oculta. me costó tiempo, y descartarlo fue una de las mejores decisiones del proyecto.
Y que en salud la IA propone, pero firma una persona. Por eso todo lo que genera el sistema llega como borrador.
Con qué está hecho
- Transcripción
- faster-whisperModelo de reconocimiento de voz de OpenAI que pasa audio a texto. Faster-Whisper es una versión más rápida que funciona en nuestro propio servidor.
small·aina-large-v3-cadel Barcelona Supercomputing Center - LLMLLM: Large Language Model (modelo de lenguaje grande). Una IA entrenada con muchísimo texto que entiende instrucciones y escribe texto nuevo, como ChatGPT o Claude.
- OllamaPrograma de código abierto para ejecutar LLMs en el propio ordenador, sin enviar nada a ningún servicio externo. Se usó durante el desarrollo.
qwen2.5:3ben desarrollo · Azure OpenAIServicio de Microsoft que da acceso a los modelos de OpenAI, como GPT, desde sus servidores. Aquí es el LLM que genera la ficha en producción.gpt-4.1-minien producción - Backend
- Python 3.11 · FastAPILibrería de Python para hacer servidores web: es la pieza que recibe las peticiones del navegador y les responde. · WebSocketConexión que queda abierta entre el navegador y el servidor para que los datos pasen en los dos sentidos sin tener que volver a pedirlos. · DockerHerramienta que empaqueta una aplicación con todo lo que necesita en un «contenedor», para que funcione igual en cualquier servidor.
- Infraestructura
- AWSAWS: Amazon Web Services. La nube de Amazon: alquila servidores y servicios por horas, sin tener que tener máquinas propias. EC2EC2: Elastic Compute Cloud. El servicio de AWS para alquilar servidores virtuales. El de este proyecto es un g4dn.xlarge, con una GPU Tesla T4.
g4dn.xlargecon Tesla T4Tarjeta gráfica (GPU) de NVIDIA pensada para servidores. Es la que lleva el servidor de AWS donde se hace la transcripción. - Idiomas
- Catalán · castellano · inglés, con detección automática
- Salidas
- Transcripción · resumen · diagnóstico · plan terapéutico · ficha SOAPSOAP: Subjetivo, Objetivo, Evaluación (Assessment) y Plan. La forma clásica de ordenar una nota clínica: qué cuenta el paciente, qué observa el profesional, qué concluye y qué se hará.
La memoria del TFGTFG: Trabajo de Fin de Grado. El proyecto final de la carrera, que se presenta y se defiende ante un tribunal. se presentó en catalán; por eso los esquemas de esta página tienen los textos en catalán.