Documentació clínica escrita
per la veu del professional
Un sistema capaç de capturar la veu del professional, transcriure-la en diferents idiomes i fer una crida a un LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude. que en retorna la informació estructurada en diferents formats. És el meu Treball de Fi de Grau, integrat a Streamly, la plataforma de gestió clínica on treballo.
- Treball Final de Grau
- UPCUPC: Universitat Politècnica de Catalunya. Aquest treball és de l'Escola Politècnica Superior d'Enginyeria de Manresa. · Manresa
- Titulació
- Enginyeria de Sistemes TIC
- Memòria
- UPCommons ↗
- Producte
- Streamly ↗
De la veu del professional a la informació estructurada
Abans d'entrar en els detalls, això és tot el que fa el sistema. Quatre passos, on el professional té l'última paraula.
- 01
Veu
El professional parla, durant la visita o fora d'ella: en directe pel micròfon o pujant un àudio ja gravat.
- 02
Transcripció
Faster-WhisperModel de reconeixement de veu d'OpenAI que passa àudio a text. Faster-Whisper n'és una versió més ràpida que funciona al nostre propi servidor. la converteix en text dins del nostre propi servidor, amb el model adequat per a cada idioma. L'àudio no surt mai d'allà.
caesen
- 03
LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude.
Rep el text amb una instrucció adaptada a l'idioma i a l'especialitat del centre. Només en treu el que s'ha dit; no s'inventa res.
- 04
Informació estructurada
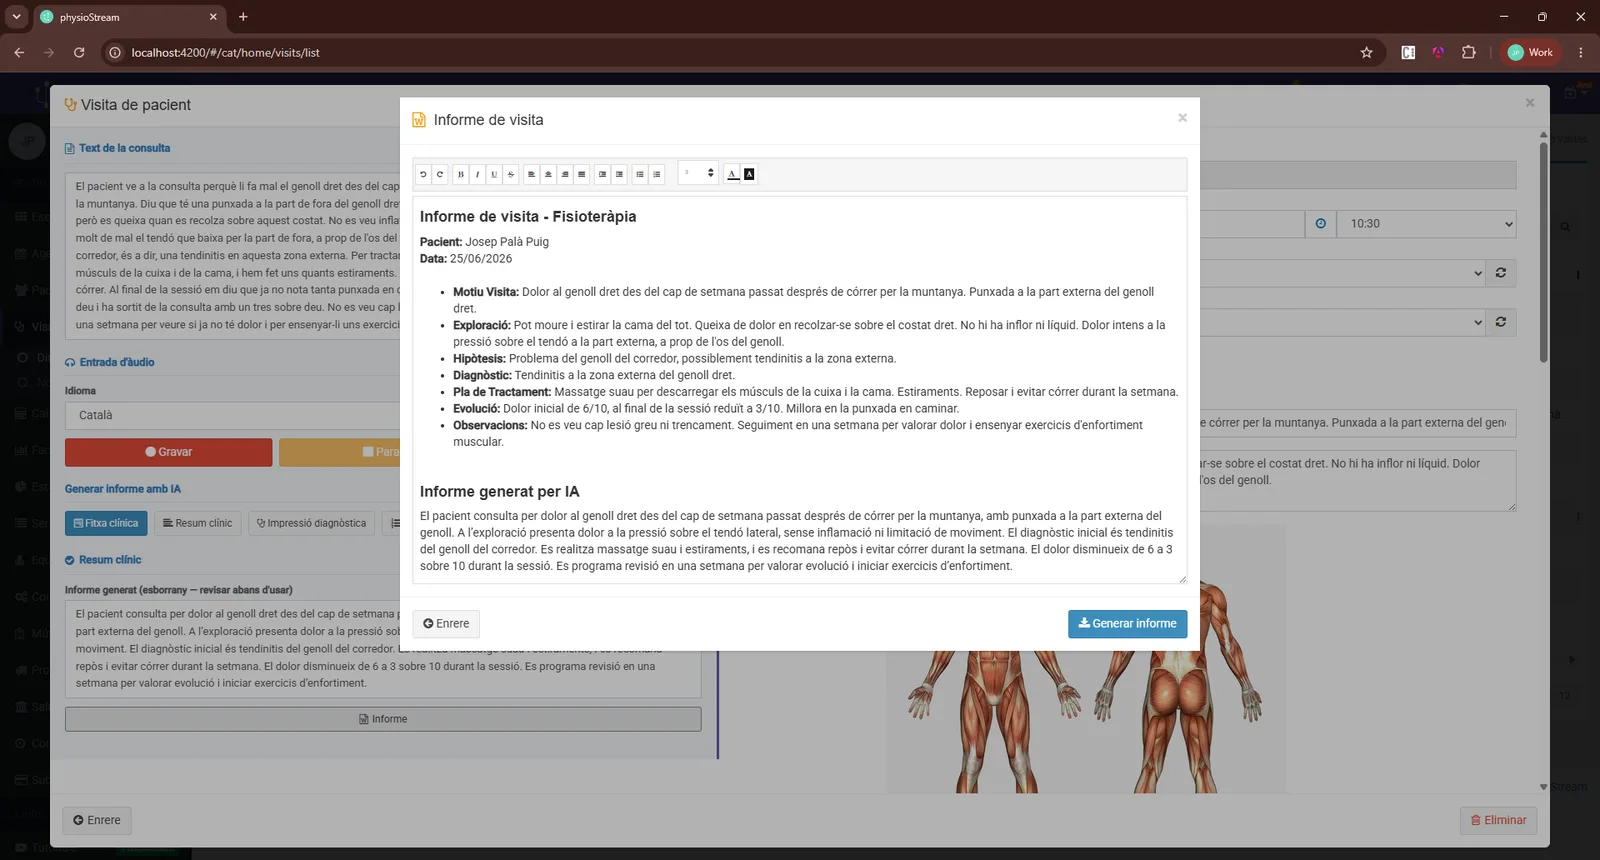
Torna en el format que tria el professional, que la revisa i la desa. Res es guarda sense que ell ho validi.
Fitxa clínicaResumDiagnòsticPla terapèutic
1,68 sper transcriure un minut d'àudio en català amb GPUGPU: Graphics Processing Unit (unitat de processament gràfic). La targeta gràfica: fa milers de càlculs alhora, i per això executa els models d'IA molt més ràpid que el processador normal.1,43 sde mitjana per generar la fitxa amb l'LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude.
L'objectiu era: automatitzar una tasca per donar temps al professional.
Que no hagi de passar estona redactant la visita o l'informe, ni durant la sessió ni després, i que aquest temps vagi al pacient. En el sector de la salut, el temps no és simplement un recurs, és la mesura directa de la qualitat de l'atenció.
I ara, en una visita real
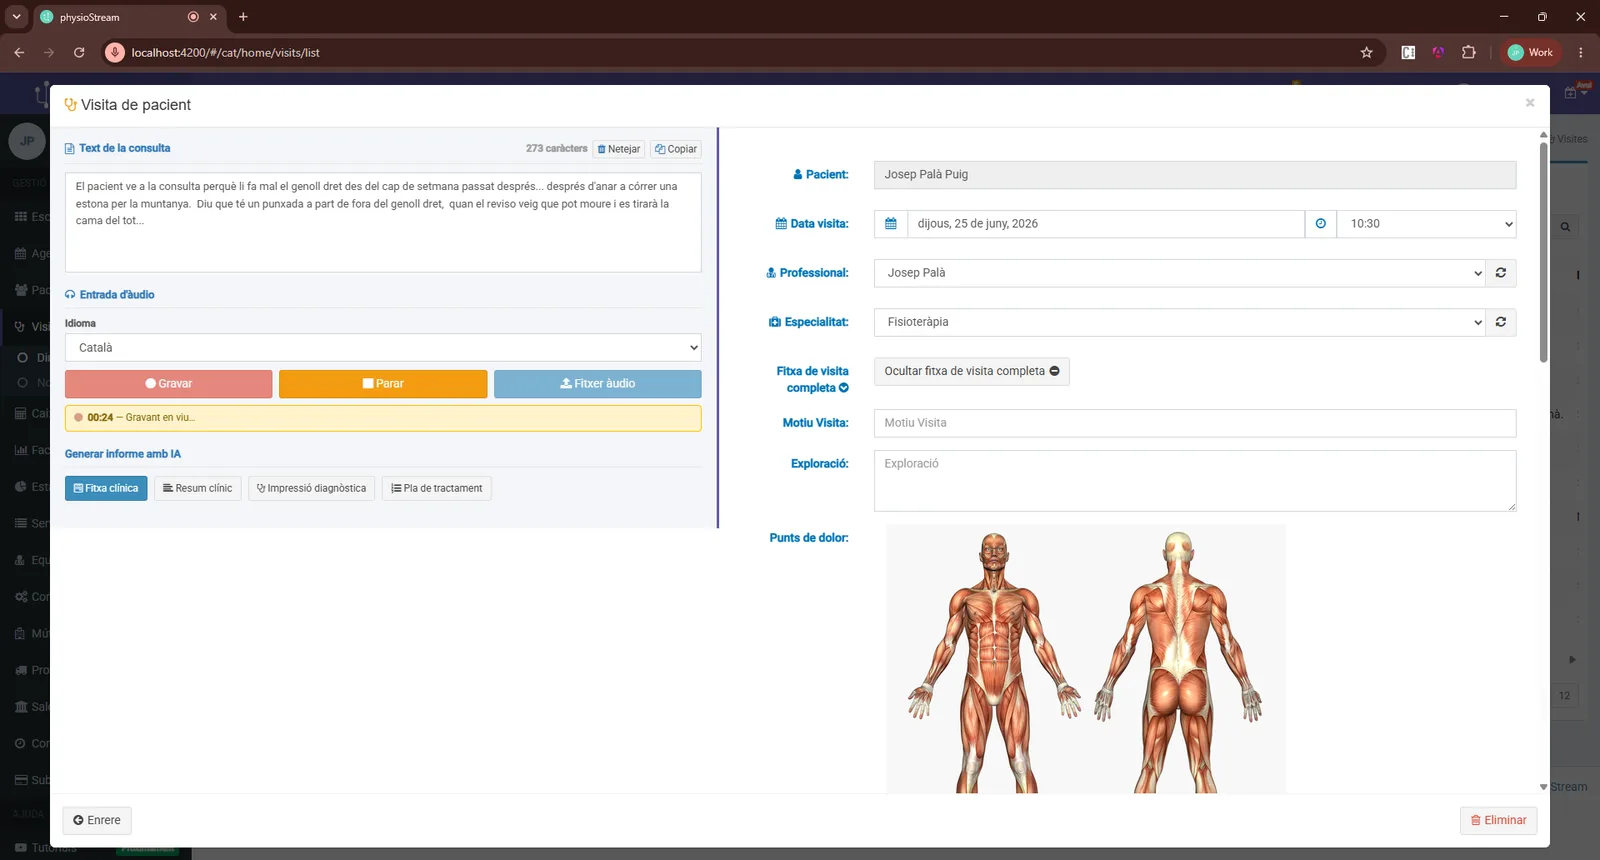
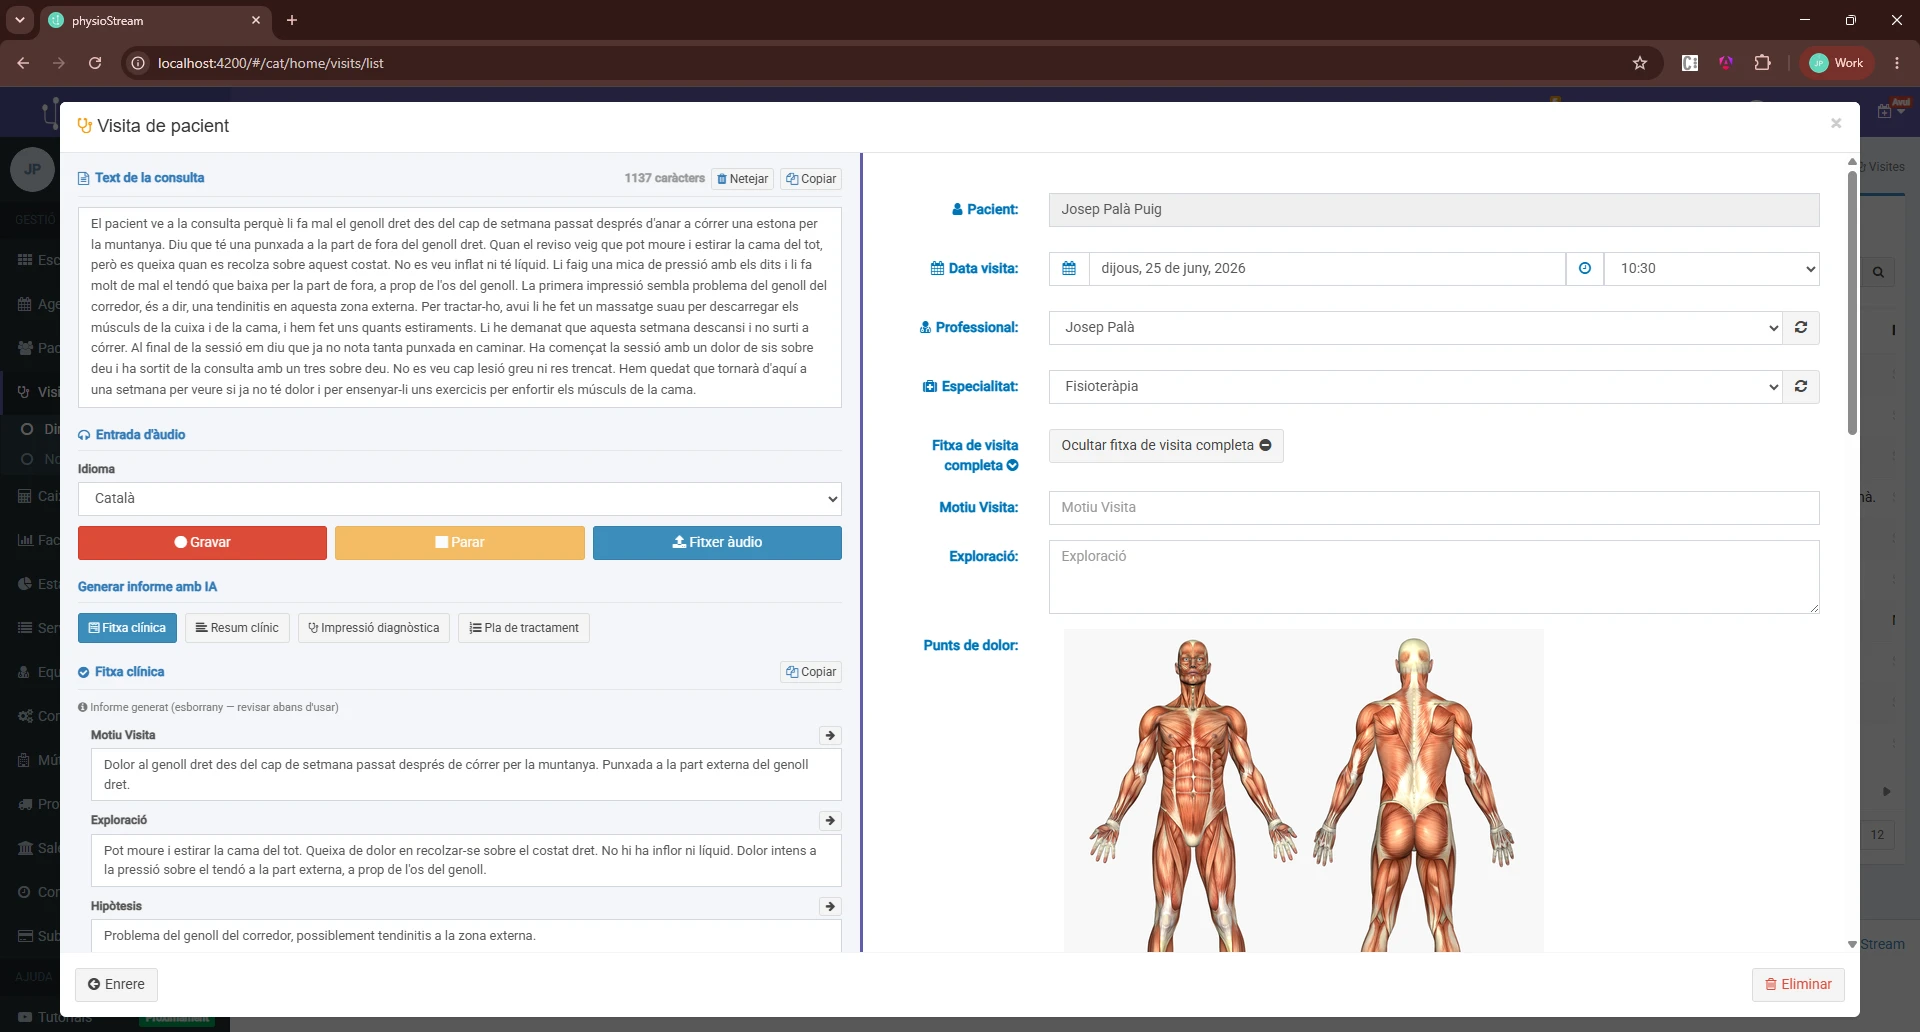
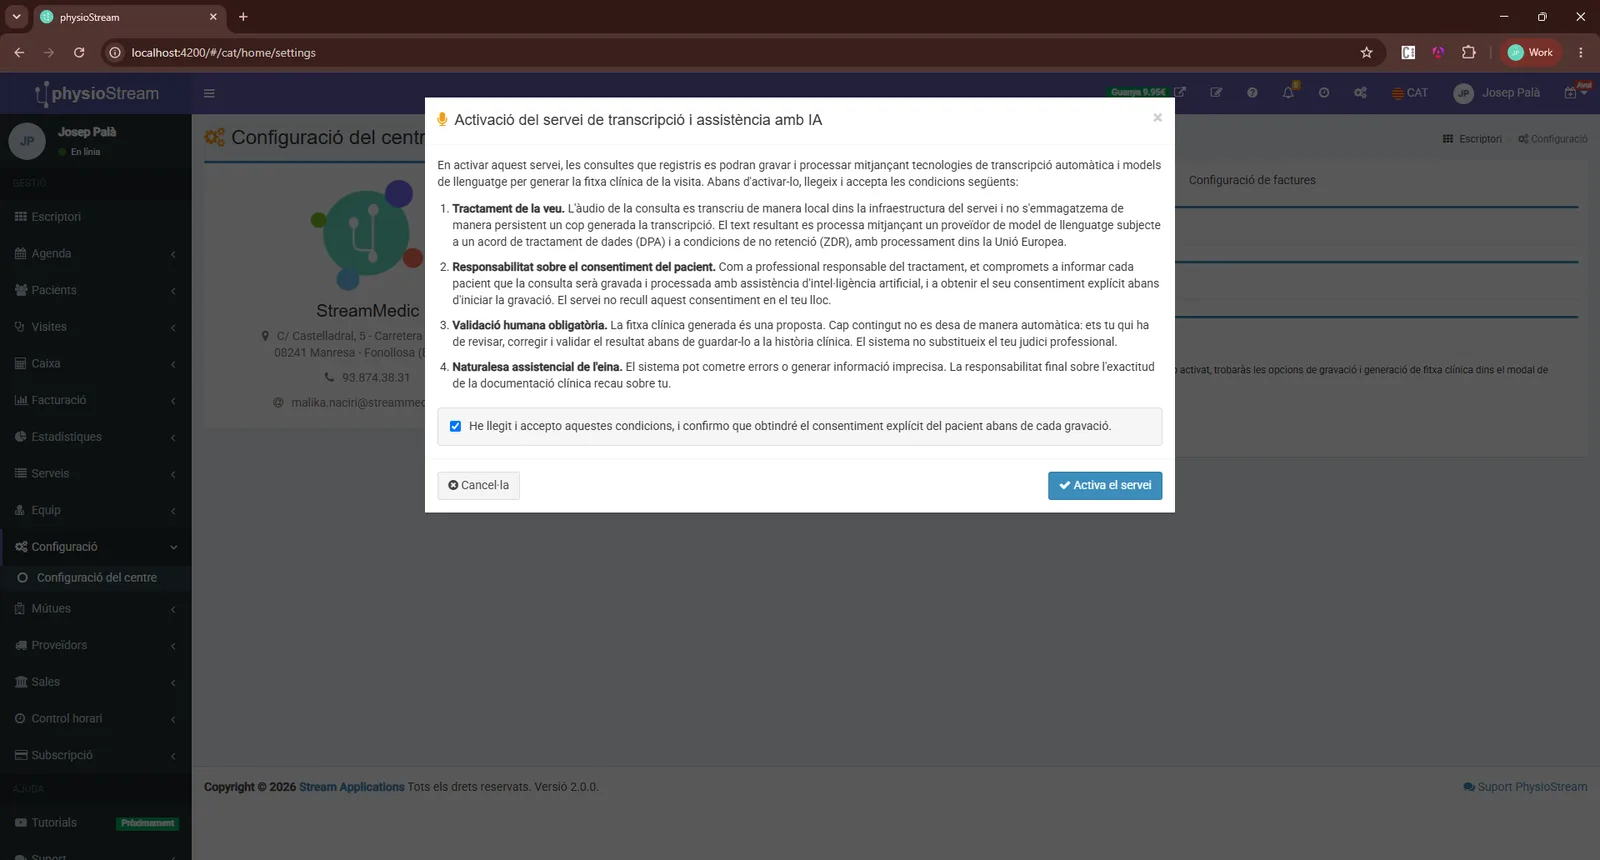
Enregistrament complet de la defensa: des de l'activació del mòdul fins a la fitxa clínica desada a la visita del pacient.
Un problema que no em vaig inventar
Vaig entrar a Streamly fent pràctiques, i el TFGTFG: Treball de Fi de Grau. El projecte final de la carrera, que es presenta i es defensa davant d'un tribunal. va arribar en el moment just. Els usuaris repetien una queixa: emplenar la fitxa de cada visita costa temps, i aquest temps el treus al pacient.
Alhora, l'empresa volia posar intel·ligència artificial al producte, però no com un adorn. Volia que servís per a alguna cosa concreta. Ajuntar les dues coses va donar forma al projecte.
Era buscar una solució a un problema real.
Van ser gairebé sis mesos, de febrer a juliol de 2026: analitzar el problema, construir el motor de transcripció, connectar el model de llenguatge, desplegar-lo al núvol i, al final, explicar-ho tot en una memòria.
Durant la sessió, la majoria de professionals només apunten el motiu de la visita o la marquen com a feta. El diagnòstic, el pla i l'evolució queden per després, en l'estona entre pacient i pacient i tirant de memòria. El resultat: històries clíniques incompletes.
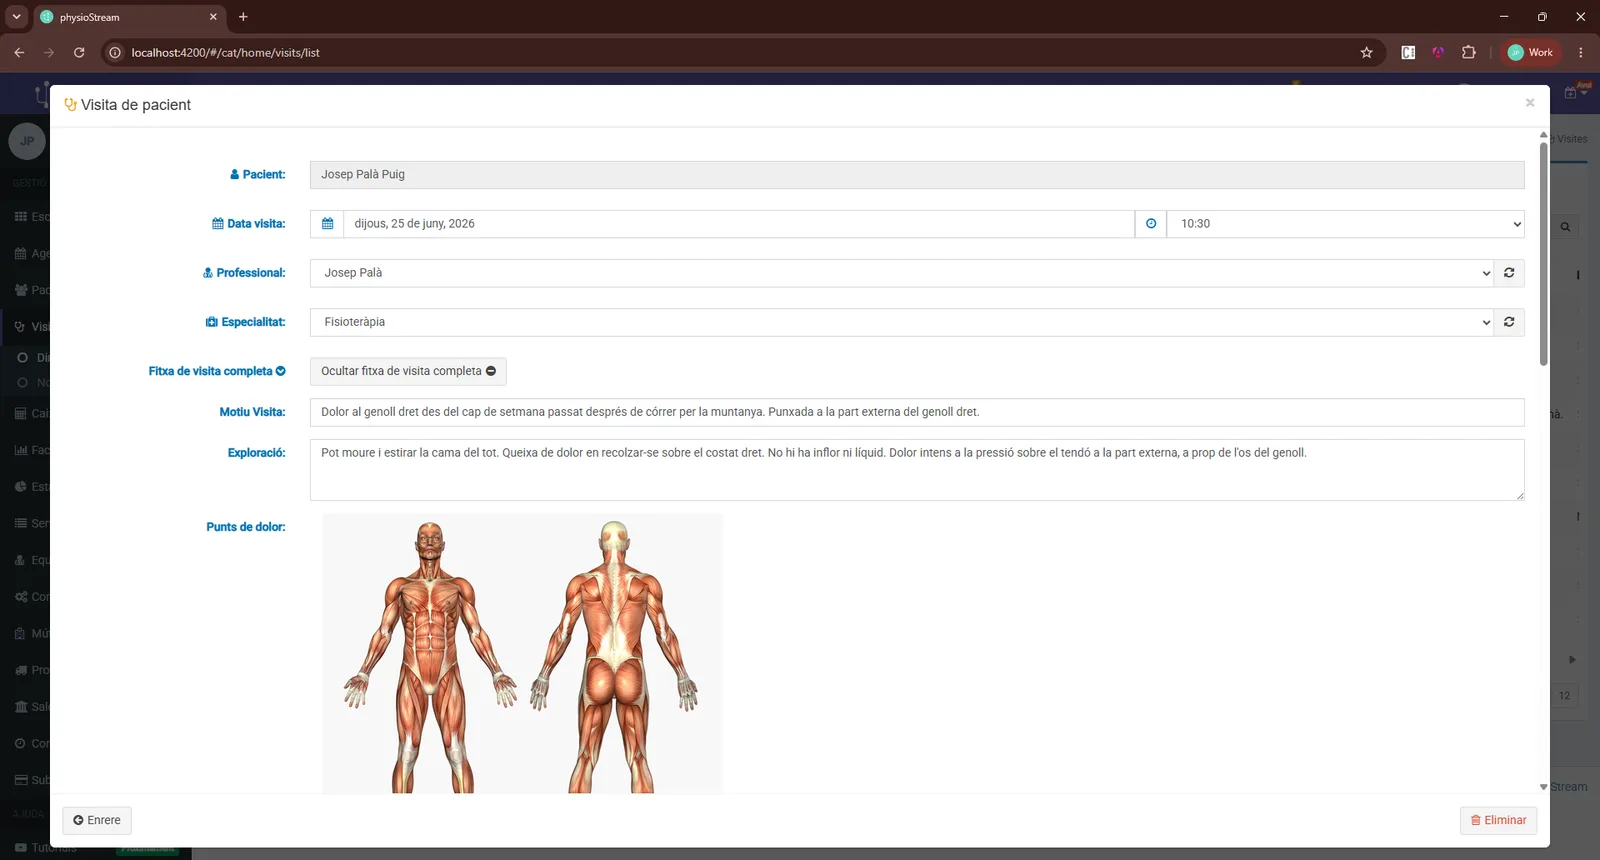
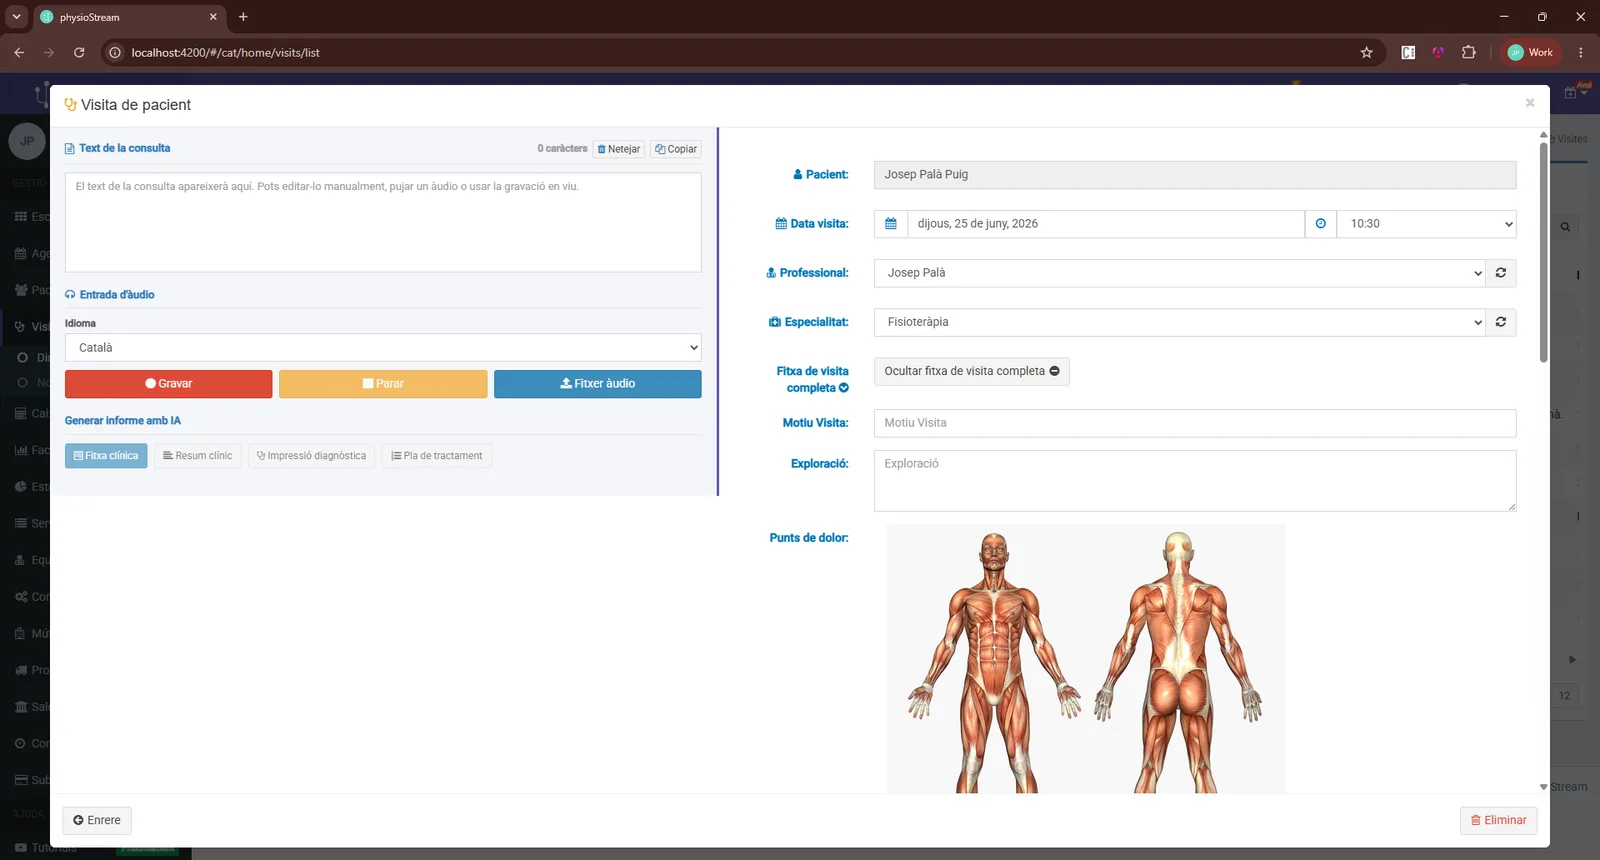
Flux del sistema d'alt nivell
Tres decisions, i totes les pren el professional
El vaig dissenyar perquè la IA no faci mai res pel seu compte. El professional activa el mòdul, decideix si vol passar el text per l'LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude. i, passi el que passi, revisa el resultat abans de desar-lo. Si el mòdul està apagat, la visita s'emplena a mà, com sempre.
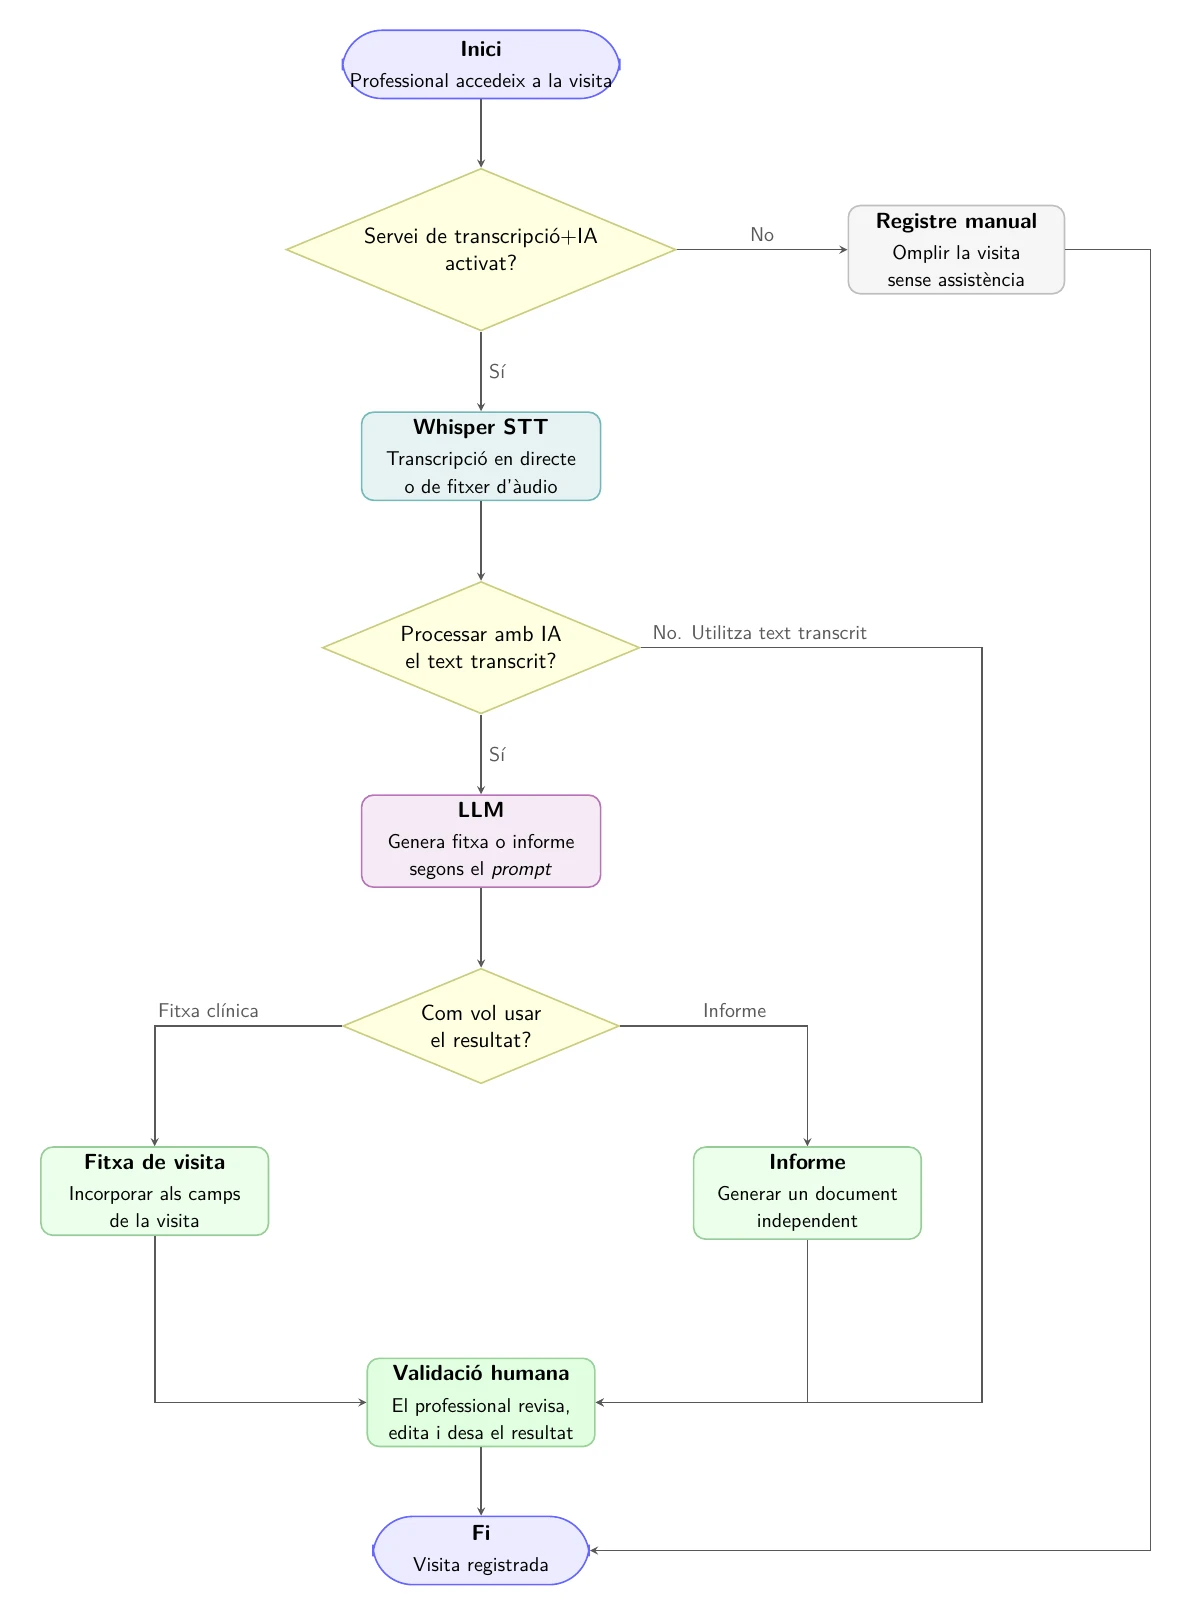
Pipeline de dades
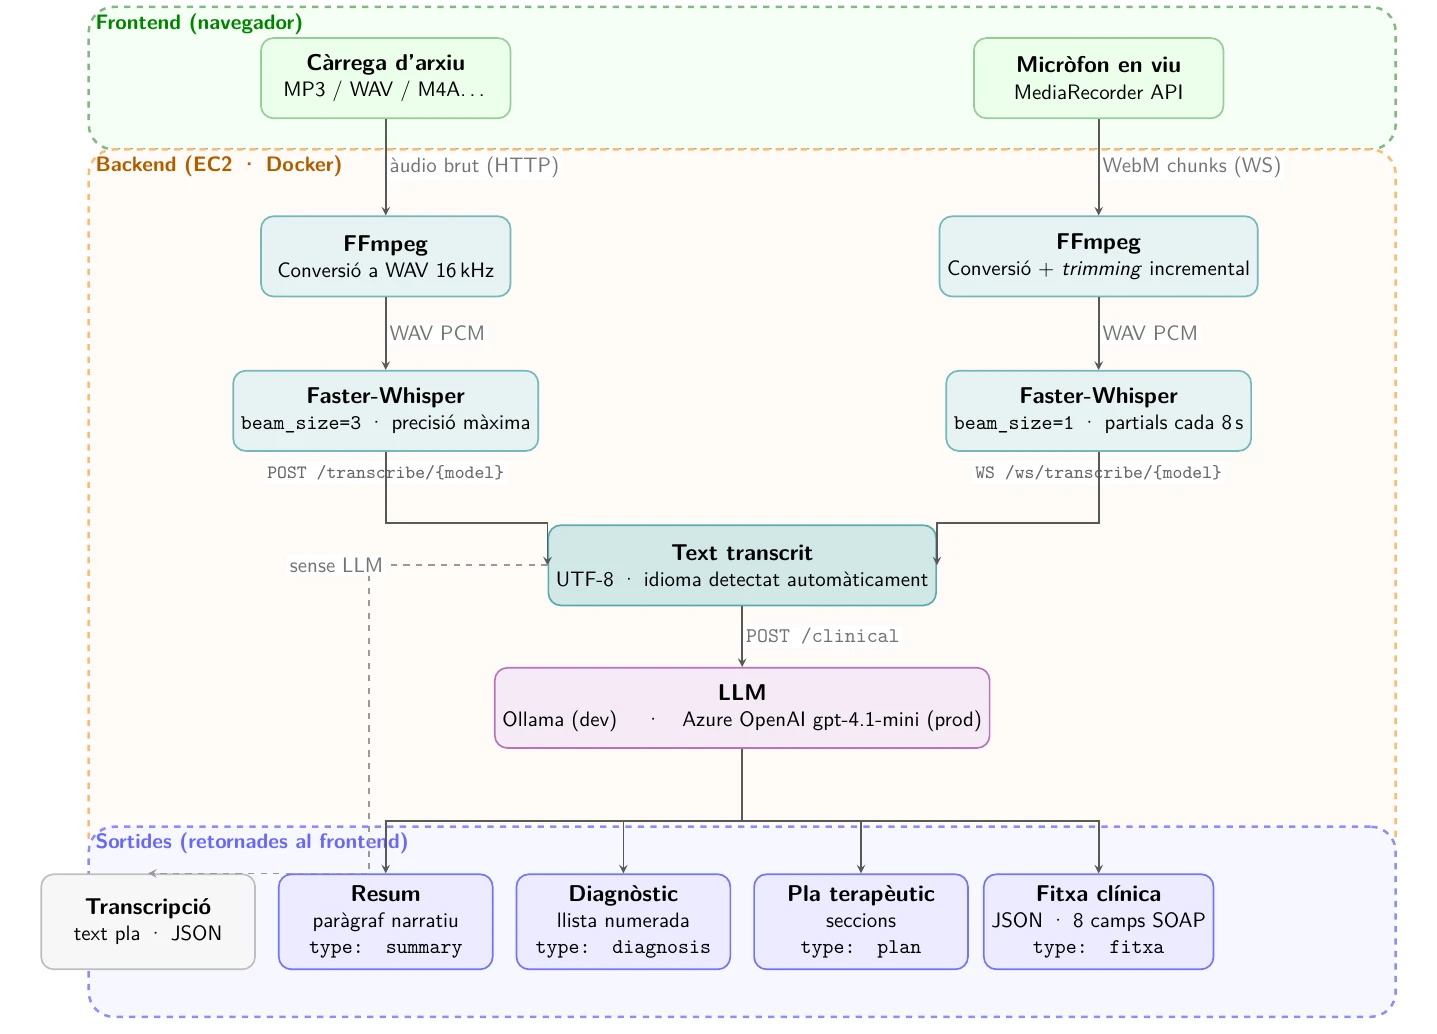
Què passa entre la veu i la fitxa
L'àudio entra per dos camins: un fitxer ja gravat o el micròfon, en directe. Tots dos acaben al mateix text transcrit, i aquí el professional tria entre quedar-se la transcripció tal qual o demanar a l'LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude. una de les quatre sortides: resum, diagnòstic, pla terapèutic o fitxa clínica.
Els detalls que no es veuen
- Transcriure mentre parles
- En directe, el navegador envia l'àudio a trossos per WebSocketConnexió que queda oberta entre el navegador i el servidor perquè les dades passin en tots dos sentits sense haver de tornar a demanar-les. i el servidor transcriu el que és nou cada vuit segons. Així el text va apareixent mentre el professional parla, no quan acaba.
- Un àudio que no sap quant dura
- El format que grava el navegador (WebMFormat d'àudio i vídeo amb què graven els navegadors. Aquí, l'àudio que surt del micròfon.) no desa la durada fins que s'acaba la gravació. Per saber quants segons portava acumulats, el servidor converteix l'àudio i el mesura amb les eines d'FFmpegPrograma de codi obert per convertir i retallar àudio i vídeo. Aquí passa l'àudio al format que necessita Whisper i en mesura la durada. cada vegada.
- Paraules tallades per la meitat
- Provant-lo vaig veure que de vegades es perdia una síl·laba just al tall entre dos trossos. La solució va ser solapar mig segon cada finestra amb l'anterior. No va sortir de cap teoria: va sortir de fer-lo servir.
- La connexió que es tancava abans d'hora
- De vegades el canal es tancava abans que arribés la transcripció final. Vaig afegir un control perquè el navegador esperi aquesta última resposta. Ho vaig validar amb més de cinquanta gravacions i menys d'un 5 % d'errors.
Cada centre té la seva pròpia fitxa
Un fisioterapeuta i un podòleg no apunten el mateix. Per això la fitxa no està escrita al codi: els camps arriben des de la configuració de cada centre a Streamly, i amb ells es construeix la instrucció que rep l'LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude.. Si un centre afegeix un camp, la fitxa l'inclou sense tocar res.
Totes les instruccions porten la mateixa regla: treure només el que es diu a la transcripció, sense inventar res. Si un camp no es menciona, es queda buit. I la temperaturaTemperatura: el paràmetre que decideix com d'arriscat és l'LLM triant cada paraula. Baixa (prop de 0): tria gairebé sempre la més probable i és previsible. Alta: s'arrisca més i és més creatiu. de l'LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude. és baixa (0,3) perquè s'arrapi al text i no es posi creatiu.
Quin model entén millor el català mèdic
Per decidir-ho vaig preparar vint àudios de veu real d'un minut, deu en català i deu en castellà. Cadascun llegeix un text clínic escrit expressament amb les paraules on aquests models solen fallar: termes com cervicàlgia o gonartrosi, referències anatòmiques i noms de pacient. La mesura és el WERWER: Word Error Rate (taxa d'error per paraula). La proporció de paraules que la transcripció canvia, afegeix o es deixa respecte al que es va dir de veritat. Com més baix, més fidel.: de cada cent paraules, quantes surten malament.
- whisper-small mitjana
- 29,65%
- aina-large-v3-ca mediana
- 12,53%
- ca_01
- ca_02
- ca_03
- ca_04al·lucinació ↓
- ca_05
- ca_06
- ca_07
- ca_08
- ca_09
- ca_10
L'error de cada àudio a la GPU de producció (Tesla T4). Passa per sobre d'un àudio o toca'l per llegir-lo sol.
El model del Barcelona Supercomputing Center passa de prop d'una paraula errònia de cada tres a una de cada vuit. En nou dels deu àudios catalans, AINAModel de reconeixement de veu especialitzat en català, del projecte AINA del Barcelona Supercomputing Center. És Whisper large-v3 ajustat amb 710 hores d'àudio en català. s'equivoca menys que whisperModel de reconeixement de veu d'OpenAI que passa àudio a text. Faster-Whisper n'és una versió més ràpida que funciona al nostre propi servidor.-small; només perd en el ca_04. Per al castellà no calia: whisper-small ja hi obté un 13,53 %, així que el model especialitzat només s'aplica al català.
Un dels vint àudios donava un error superior al 100 %. Semblava un error de mesura, però no ho era: en arribar a un tram final amb poca veu, el model entrava en bucle i s'inventava text que no era a l'àudio.
D'aquí surten dues decisions. La xifra que es publica és la mediana, perquè aquest sol cas empenyia la mitjana fins al 18,78 %. I la revisió del professional va quedar com a pas obligatori: cap sistema de transcripció automàtica està lliure de fallar en un cas concret, per bo que sigui el seu error mitjà.
Per què el sistema necessita GPU
AINAModel de reconeixement de veu especialitzat en català, del projecte AINA del Barcelona Supercomputing Center. És Whisper large-v3 ajustat amb 710 hores d'àudio en català. és més precís, però també molt més pesat. La diferència entre processar-lo amb el processador normal o amb una targeta gràfica decideix si el sistema es pot fer servir durant la consulta o no.
Transcriure un àudio d'un minut amb AINA
Tesla T4Targeta gràfica (GPU) de NVIDIA pensada per a servidors. És la que porta el servidor d'AWS on es fa la transcripció.. Prou ràpid per transcriure mentre dura la visita.
Vint-i-nou vegades més lent. Inviable amb el pacient al davant.
Animació accelerada ×8. Els segons són els mesurats.
Del portàtil al núvol
La primera versió funcionava sencera al meu portàtil: el servidor, la transcripció, un LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude. local i una capa per anonimitzar el text. Funcionava, però era lenta i no es podia ensenyar a ningú. La versió final viu en un servidor amb GPUGPU: Graphics Processing Unit (unitat de processament gràfic). La targeta gràfica: fa milers de càlculs alhora, i per això executa els models d'IA molt més ràpid que el processador normal. a AWSAWS: Amazon Web Services. El núvol d'Amazon: lloga servidors i serveis per hores, sense haver de tenir màquines pròpies., empaquetada en DockerEina que empaqueta una aplicació amb tot el que necessita en un «contenidor», perquè funcioni igual en qualsevol servidor., i només el text surt cap a Azure OpenAIServei de Microsoft que dona accés als models d'OpenAI, com GPT, des dels seus servidors. Aquí és l'LLM que genera la fitxa en producció. per generar la fitxa.
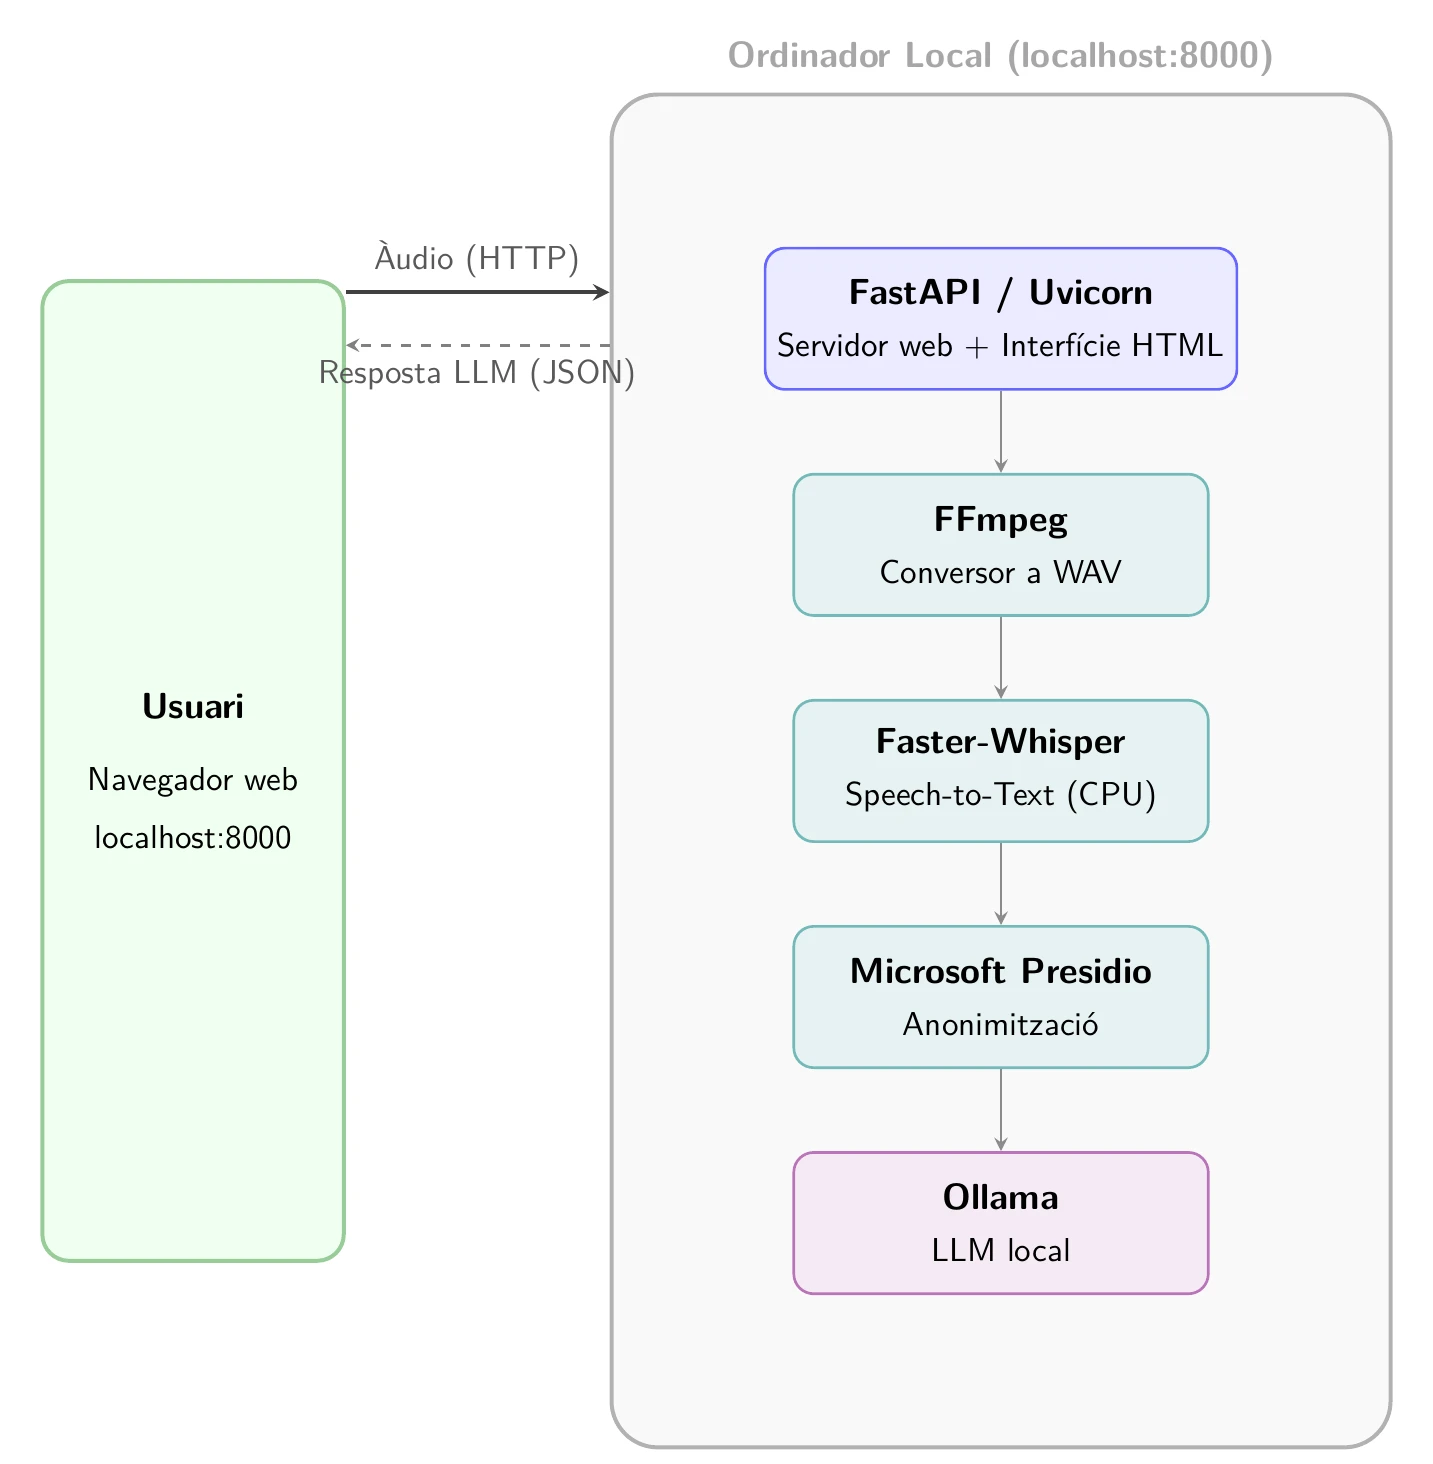
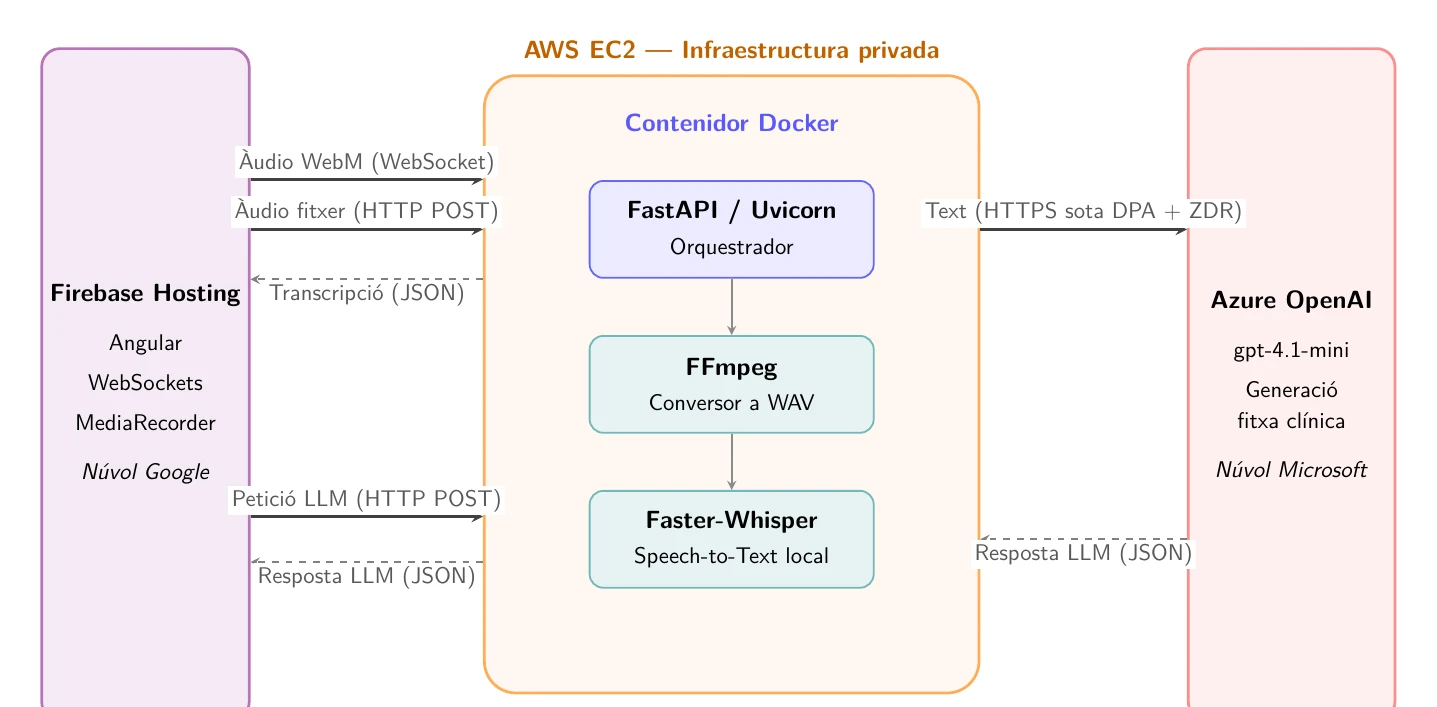
Una de les decisions que més em va ensenyar va ser treure una cosa que ja funcionava: la capa d'anonimització.
Sobre el paper era bona idea: abans d'enviar el text a l'LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude., Microsoft PresidioEina de codi obert de Microsoft que busca dades personals en un text (noms, telèfons, DNI…) i les amaga. buscava noms, telèfons o DNI i els substituïa. Però amb textos clínics en català fallava pels dos costats. Marcava com a dades personals paraules com «pàdel» o «drenatge» i, en canvi, deixava passar noms i cognoms reals. Espatllava el text que rebia l'LLM i, a sobre, donava una falsa sensació de seguretat. Una protecció que funciona a mitges pot ser pitjor que no tenir-ne, així que la vaig treure i vaig canviar l'enfocament: l'àudio no surt mai de la infraestructura, i el text viatja amb garanties contractuals.
La veu no surt de la infraestructura
El RGPDRGPD: Reglament General de Protecció de Dades. La llei europea que regula com es poden fer servir les dades personals; les de salut hi tenen la protecció més estricta. classifica les dades de salut com a categoria especial, el règim més estricte. Això condiciona l'arquitectura abans que cap decisió de model: la transcripció s'executa sempre dins la infraestructura controlada i, avui, l'àudio no viatja mai a cap tercer.
Àudio, sempre local
Faster-WhisperModel de reconeixement de veu d'OpenAI que passa àudio a text. Faster-Whisper n'és una versió més ràpida que funciona al nostre propi servidor. corre dins la mateixa màquina que rep l'enregistrament. El fitxer d'àudio no surt en cap moment de la infraestructura del projecte.
Què costa i cap a on aniria
Avui la peça cara és el servidor amb GPUGPU: Graphics Processing Unit (unitat de processament gràfic). La targeta gràfica: fa milers de càlculs alhora, i per això executa els models d'IA molt més ràpid que el processador normal.: està encès tot el dia, es faci servir o no, i transcriu els àudios d'un en un. Per això els objectius finals del treball apuntaven a treure aquest cost fix del mig.
476€/mes
Cost operatiu
Instància amb GPUGPU: Graphics Processing Unit (unitat de processament gràfic). La targeta gràfica: fa milers de càlculs alhora, i per això executa els models d'IA molt més ràpid que el processador normal. i LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude., en un escenari de mil consultes diàries.
0€
Transcripció
No hi ha cost per ús: el model corre a la infraestructura pròpia.
- Tot per API
- Fer la transcripció i la fitxa amb crides a l'APIAPI: Application Programming Interface (interfície de programació). La porta per on un programa demana coses a un altre servei, per exemple enviar un àudio i rebre'n el text. d'OpenAI, sense un servidor propi per transcriure. Durant el treball es va descartar perquè l'àudio havia de sortir de la infraestructura; l'objectiu era trobar una opció que ho permetés amb les mateixes garanties que ja té el text: regió europea, contracte i sense retenció de dades.
- Servidors sota demanda
- Una infraestructura tipus KubernetesSistema que gestiona molts contenidors Docker alhora: n'engega més quan hi ha feina, els apaga quan no n'hi ha i en reinicia un si cau. que aixequi servidors amb la imatge DockerEina que empaqueta una aplicació amb tot el que necessita en un «contenidor», perquè funcioni igual en qualsevol servidor. quan hi ha feina i els apagui quan no n'hi ha. Així el cost seguiria l'ús real, en lloc de pagar sempre pel moment de més demanda.
Funciona. Una altra cosa és activar-lo
El sistema està integrat a Streamly i funciona a l'entorn de preproducció. El que falta per fer-lo servir amb pacients no és tecnologia.
Hi ha dues barreres. La primera és el cost: la GPUGPU: Graphics Processing Unit (unitat de processament gràfic). La targeta gràfica: fa milers de càlculs alhora, i per això executa els models d'IA molt més ràpid que el processador normal. transcriu els àudios d'un en un, així que quan molts professionals el fan servir alhora no n'hi ha prou de pagar una mica més; cal afegir un altre servidor sencer, uns 443 € més al mes cada vegada. La segona és legal: treballar amb dades de salut de pacients reals exigeix signar el contracte amb el proveïdor, fer una avaluació d'impacte i definir com es demana el consentiment.
El prototip demostra que el camí és viable. Recórrer-lo depèn de decisions d'empresa, no de codi.
I queda una pregunta sense resposta: quants minuts estalvia de veritat a cada visita. Per saber-ho cal un estudi amb professionals fent-lo servir en el seu dia a dia, i és el primer que faria abans de desplegar-lo.
Què m'emporto
A mesurar abans de decidir. Triar AINAModel de reconeixement de veu especialitzat en català, del projecte AINA del Barcelona Supercomputing Center. És Whisper large-v3 ajustat amb 710 hores d'àudio en català. per al català no va ser una intuïció: van ser vint àudios i una taula.
Que treure també és dissenyar. PresidioEina de codi obert de Microsoft que busca dades personals en un text (noms, telèfons, DNI…) i les amaga. em va costar temps, i descartar-lo va ser una de les millors decisions del projecte.
I que en salut la IA proposa, però signa una persona. Per això tot el que genera el sistema arriba com a esborrany.
Amb què està fet
- Transcripció
- faster-whisperModel de reconeixement de veu d'OpenAI que passa àudio a text. Faster-Whisper n'és una versió més ràpida que funciona al nostre propi servidor.
small·aina-large-v3-cadel Barcelona Supercomputing Center - LLMLLM: Large Language Model (model de llenguatge gran). Una IA entrenada amb molt de text que entén instruccions i n'escriu de nou, com ChatGPT o Claude.
- OllamaPrograma de codi obert per executar LLMs al propi ordinador, sense enviar res a cap servei extern. Es va fer servir durant el desenvolupament.
qwen2.5:3ben desenvolupament · Azure OpenAIServei de Microsoft que dona accés als models d'OpenAI, com GPT, des dels seus servidors. Aquí és l'LLM que genera la fitxa en producció.gpt-4.1-minien producció - Backend
- Python 3.11 · FastAPILlibreria de Python per fer servidors web: és la peça que rep les peticions del navegador i hi respon. · WebSocketConnexió que queda oberta entre el navegador i el servidor perquè les dades passin en tots dos sentits sense haver de tornar a demanar-les. · DockerEina que empaqueta una aplicació amb tot el que necessita en un «contenidor», perquè funcioni igual en qualsevol servidor.
- Infraestructura
- AWSAWS: Amazon Web Services. El núvol d'Amazon: lloga servidors i serveis per hores, sense haver de tenir màquines pròpies. EC2EC2: Elastic Compute Cloud. El servei d'AWS per llogar servidors virtuals. El d'aquest projecte és un g4dn.xlarge, amb una GPU Tesla T4.
g4dn.xlargeamb Tesla T4Targeta gràfica (GPU) de NVIDIA pensada per a servidors. És la que porta el servidor d'AWS on es fa la transcripció. - Idiomes
- Català · castellà · anglès, amb detecció automàtica
- Sortides
- Transcripció · resum · diagnòstic · pla terapèutic · fitxa SOAPSOAP: Subjectiu, Objectiu, Avaluació i Pla. La manera clàssica d'ordenar una nota clínica: què explica el pacient, què observa el professional, què en conclou i què es farà.